 ecbyts
Cómo usar ecbyts como entorno de aprendizaje por refuerzo ambiental
Lectura estimada: 7 min
- Guía
- Audio
- Tour
Entrenar un algoritmo que decide sobre un terreno contaminado choca con un problema práctico: no hay dónde equivocarse sin generar pasivo. ecbyts entra como entorno — el gemelo digital que devuelve estado, recompensa y consecuencia.
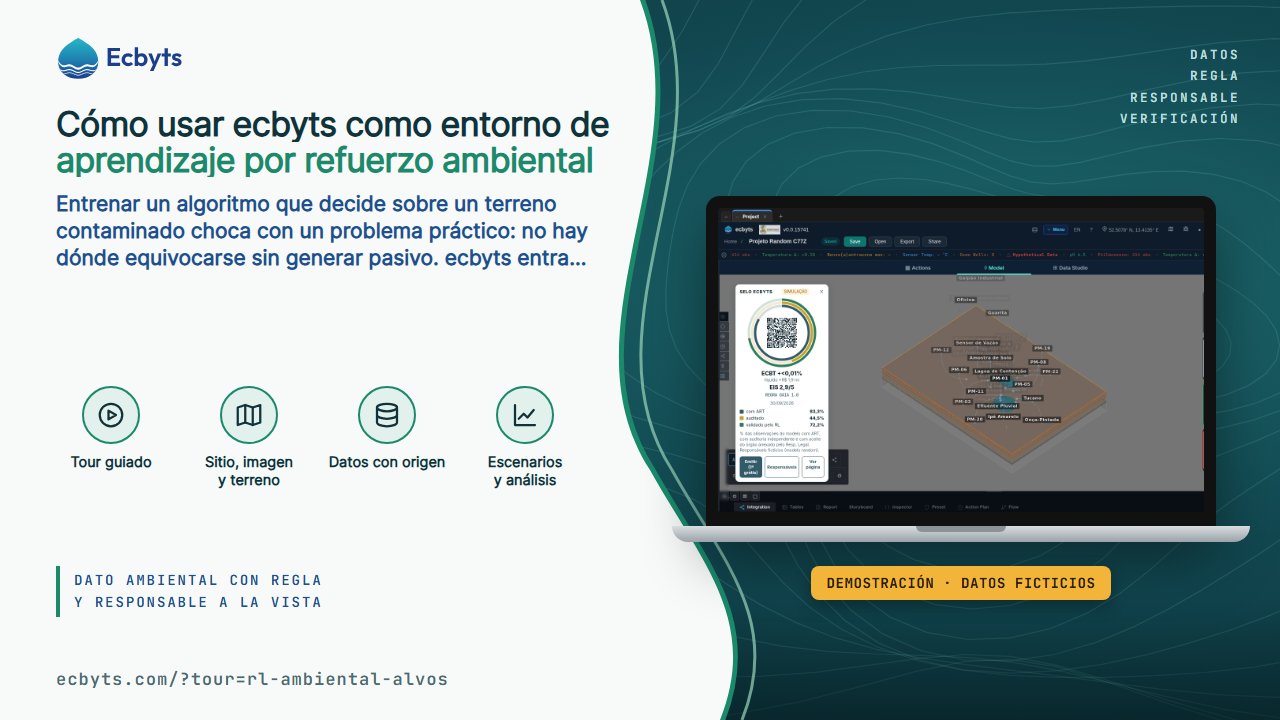
Un equipo de ciencia de datos entrena un agente para jugar al ajedrez en una tarde. Pídele lo mismo para decidir dónde abrir un pozo de investigación en un área contaminada — un proyecto de GAC, el término brasileño para el gerenciamiento de áreas contaminadas — y el proyecto se detiene. No por falta de algoritmo: porque no hay lugar seguro donde el agente se equivoque.
El error en campo cuesta caro y tarda en aparecer: una campaña de muestreo lleva semanas, y un pozo mal ubicado no cuenta como intento fallido — cuenta como pasivo.
Antes de elegir el algoritmo, la pregunta que decide el proyecto es otra: ¿dónde puede este agente equivocarse mil veces sin generar pasivo?
Qué es el aprendizaje por refuerzo, sin jerga
El aprendizaje por refuerzo enseña a un programa por ensayo y consecuencia, como adiestrar a un perro: acertó, gana punto; falló, pierde. La diferencia es que el punto es una cuenta matemática, no una galleta.
Cinco palabras sostienen todo:
- Agente: el programa que decide.
- Estado: la foto del mundo en ese instante — qué se midió, dónde, cuándo y qué falta.
- Acción: lo que elige hacer: contratar una campaña, cambiar la ruta de remediación, priorizar un punto.
- Recompensa: el número que dice si la acción fue buena.
- Política: la regla que une estado y acción, y lo que se lleva al campo.
Una vuelta completa — ver, actuar, recibir la recompensa, corregir la política — es un episodio. En laboratorio cuesta milisegundos; en campo, dinero y plazo.
El cuello de botella es el entorno, no el algoritmo
Hay bibliotecas listas para casi cualquier algoritmo de refuerzo. Lo que no existe es un entorno que responda «¿qué pasa si hago esto?» con un número defendible.
Para servir de entorno, un sistema tiene que ser rápido, determinista, anclado en el dato real, auditable y honesto sobre lo que no sabe. Una hoja de cálculo falla en los cinco: no propaga incertidumbre, no rechaza combinaciones físicamente imposibles y no guarda qué versión del dato entró en la cuenta.
ecbyts como entorno: el gemelo digital que responde
ecbyts es un gemelo digital ambiental: el modelo del proyecto dentro del navegador, con elementos (pozos, áreas, fuentes), observaciones fechadas por campaña y cálculos que dejan rastro. El estado del entorno es ese modelo, no su descripción en prosa.
Para un agente externo, el estado llega por tres vías: el Agent Hub, que muestra lo que un agente lee del modelo — elementos, campañas, vacíos y herramientas; la API; y MCP, el protocolo que conecta asistentes con herramientas. La lectura es determinista y viaja con prueba: un sello de integridad (el proofStamp, una huella SHA-256) y un árbol de Merkle, que prueba que un ítem no cambió sin reenviar el conjunto.
Dos trabas importan:
- El MCP hospedado hoy es de solo lectura: entrega estado, no acepta comandos.
- Escribir exige aprobación en dos puntas: quien opera el agente y quien responde por el modelo deben acordar.
Y el límite que no es promesa: la actuación directa sobre sensores y válvulas en tiempo real es Visión — aún no disponible.
El camino más corto para verlo es el tour guiado de los objetivos del aprendizaje por refuerzo.
Los objetivos: dónde se calcula la recompensa
ECBT Score: el saldo, con la incertidumbre dentro del número
El ECBT Score compara el valor ambiental que existe hoy con el costo de resolver el pasivo y devuelve un saldo en reales, junto al ECBT %, la proporción entre los dos lados. El número grande es el saldo; la banda alrededor es la incertidumbre.
El ancho de esa banda depende de la confianza en los datos, resumida en κ (la letra griega kappa): cuanto menor el κ, más ancha la banda, que puede llegar al triple de ancho. Así, una ganancia frágil no puede leerse como cierta. Míralo en el panel del ECBT Score. Y recuerda: es un indicador de simulación, no un informe técnico.
EIS: la nota de integridad de la evidencia, de 0 a 5
El EIS pone nota de 0 a 5 a la evidencia en cuatro frentes: cobertura (cuánto se midió), método (si la colecta siguió un procedimiento reconocido), auditoría (si alguien independiente revisó) y rastro (si se puede reconstruir de dónde salió cada número).
Es lo que define el κ: κ = EIS ÷ 5. EIS 5 da κ = 1, confianza máxima; EIS 2,5 da κ = 0,5, y la banda del ECBT Score se abre. El panel del EIS muestra el anillo de la nota y el aporte de cada criterio.
La Calculadora como objetivo opcional
Cuando la meta no es dinero ni nota general, la Calculadora arma el objetivo a medida: promedio de un parámetro, razón entre dos parámetros o regla contra un límite legal — por ejemplo, cuántos pozos quedaron por encima del Valor de Investigación. Los ítems listos, como el ECBT Score, aparecen en la misma lista.
Usa la regla para metas de límite duro; usa una razón cuando cuenta la proporción.
La acción, probada antes: el comparador de escenarios
Un agente necesita acciones con efecto visible. En el comparador de escenarios, la Base queda fija, cada escenario cambia una hipótesis y la app rechaza combinaciones físicamente imposibles, como un rendimiento mayor que la recuperación. El efecto aparece en el ECBT Score y en los ODS. Y el aviso sigue vigente: la simulación no es medición.
Por qué ECBT Score y EIS juntos cierran el atajo
Si la recompensa es solo dinero, el camino más corto es recortar costo — y el costo más fácil de recortar es el monitoreo. El agente «aprende» a hacer menos campañas, el saldo mejora en el papel y el pasivo sigue ahí, ahora con menos evidencia encima. Es el problema de la recompensa de un solo eje: el algoritmo optimiza el número que le diste, no la intención que tenías.
Dos cosas rompen el atajo:
- El EIS entra en la recompensa. Recortar campañas baja la cobertura, y la nota cae.
- El κ cae con ella. La banda del ECBT Score se abre, y la ganancia deja de ser cierta.
Queda una recompensa de dos ejes: saldo y confianza. El agente solo gana cuando gana en los dos. Quien define el objetivo define el comportamiento.
Entrenar un modelo sustituto rápido dentro de la app
Correr el motor completo miles de veces es caro. La salida es el modelo sustituto (surrogate): una red pequeña que imita la salida del motor con un error conocido, barre las combinaciones en segundos y deja los puntos interesantes para confirmar en el motor completo.
ecbyts lo hace en ML Studio, dentro del navegador, sin servidor ni Python. Eliges entradas y salida; las variables calculadas — EIS, ECBT Score e ítems de la Calculadora — entran como entrada o salida, así el indicador puede ser objetivo de entrenamiento.
Tres cuidados: la red estima, no mide; fuera del rango de entrenamiento la estimación es una conjetura con apariencia de número; y el sustituto acelera la búsqueda, pero no decide. Ninguna red neuronal ni política aprendida altera dato medido ni firma en lugar del Responsable Técnico — el ingeniero que responde por la ART. El Sello ECBYTS separa en pantalla lo que es máquina de lo que tiene ART y atestación humana.
Límites honestos
- La simulación no es medición. Donde no hay medición, hay estimación declarada.
- El dato de demostración es ficticio. Los números del tour no describen ningún terreno real.
- Sensores y válvulas en tiempo real: Visión — aún no disponible.
- MCP hospedado: solo lectura; escribir pasa por aprobación en dos puntas.
- El indicador no es un informe. No sustituye informe técnico, opinión del órgano ambiental ni ART.
- El entorno tiene los límites del dato que recibió. Una campaña faltante es un vacío visible, nunca un cero.
Conclusión
El cuello de botella del aprendizaje por refuerzo en medio ambiente nunca fue la matemática. Fue la ausencia de un lugar donde equivocarse sea barato y la consecuencia, un número comparable. ecbyts entrega ese lugar: estado legible por el agente, acciones probadas en escenario y una recompensa de dos ejes que se vigilan.
El algoritmo lo eliges tú. La recompensa, la respondes tú.
Empieza por el tour guiado de los objetivos y lleva una pregunta al primer escenario: ¿cuál es el atajo que tu agente encuentra antes de encontrar la solución?