 ecbyts
Como usar o ecbyts como ambiente de aprendizado por reforço ambiental
Leitura estimada: 7 min
- Guia
- Áudio
- Tour
Treinar um algoritmo que decide sobre um terreno contaminado esbarra em um problema prático: não há onde errar sem produzir passivo. O ecbyts entra como ambiente — o gêmeo digital que devolve estado, recompensa e consequência.
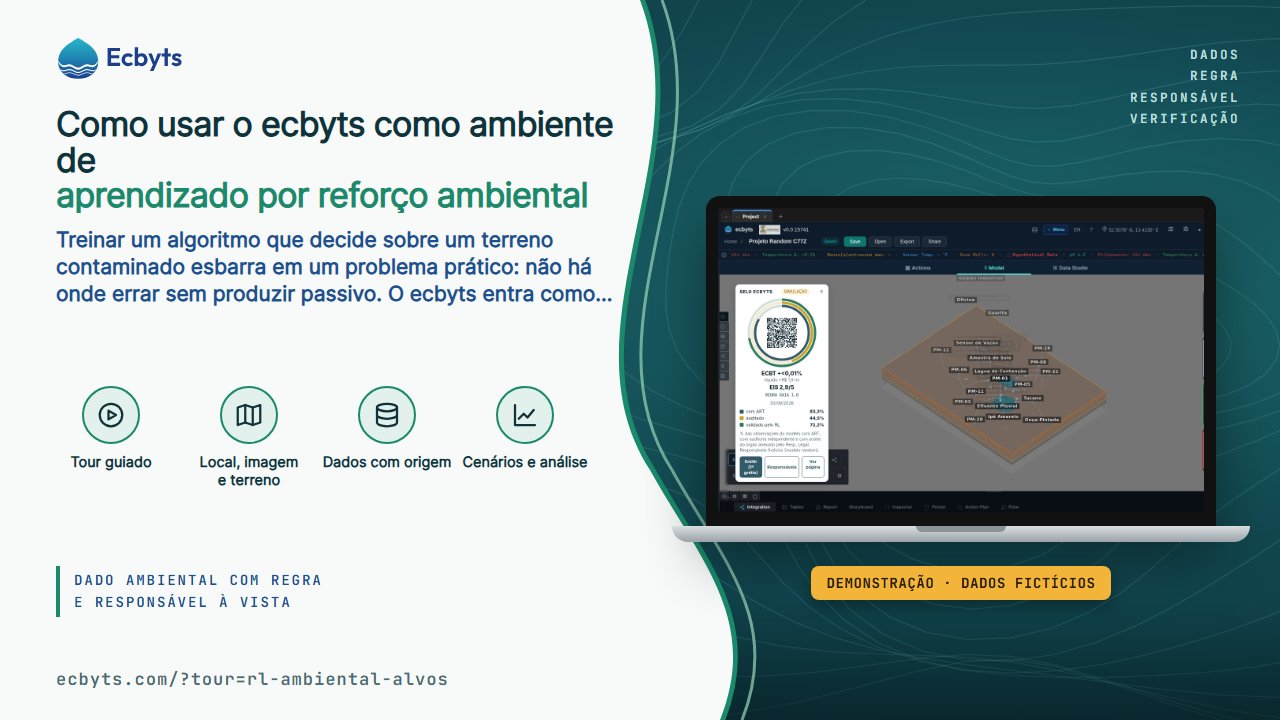
Um time de ciência de dados treina um agente para jogar xadrez em uma tarde. Peça o mesmo para decidir onde abrir um poço de investigação em uma área contaminada — um projeto de GAC, Gerenciamento de Áreas Contaminadas — e o projeto para. Não por falta de algoritmo: porque não existe lugar seguro para o agente errar.
O erro em campo custa caro e demora a aparecer: uma campanha de amostragem leva semanas entre mobilização, coleta, laboratório e validação, e um poço mal posicionado não conta como tentativa frustrada — conta como passivo.
Antes de escolher o algoritmo, a pergunta que decide o projeto é outra: onde este agente pode errar mil vezes sem produzir passivo?
O que é aprendizado por reforço, sem jargão
Aprendizado por reforço (em inglês, reinforcement learning) ensina um programa por tentativa e consequência, como adestrar um cão: acertou, ganha ponto; errou, perde. A diferença é que o ponto é uma conta matemática.
Cinco palavras sustentam tudo:
- Agente: o programa que decide.
- Estado: o retrato do mundo naquele instante — o que foi medido, onde, quando e o que falta.
- Ação: o que ele escolhe fazer: contratar campanha, mudar a rota de remediação, priorizar um ponto.
- Recompensa: o número que diz se a ação foi boa.
- Política: a regra que liga estado a ação e que você leva para a vida real.
Uma rodada completa — ver, agir, receber recompensa, corrigir a política — é um episódio. Em laboratório ele custa milissegundos; em projeto ambiental, custa dinheiro e prazo.
O gargalo é o ambiente, não o algoritmo
Há biblioteca pronta para quase todo algoritmo de aprendizado por reforço. O que não existe é um ambiente que responda "o que acontece se eu fizer isso?" com um número defensável.
Para servir de ambiente, um sistema precisa ser rápido, determinístico, lastreado no dado real, auditável e honesto sobre o que não sabe. Uma planilha falha nos cinco: não propaga incerteza, não recusa combinação fisicamente impossível e não guarda qual versão do dado entrou na conta.
O ecbyts como ambiente: o gêmeo digital que responde
O ecbyts é um gêmeo digital ambiental: o modelo do projeto dentro do navegador, com elementos (poços, áreas, fontes), observações datadas por campanha e cálculo com rastro. O estado do ambiente é esse modelo, não uma descrição em prosa dele.
Para um agente externo, o estado chega por três caminhos: o Agent Hub, que mostra na tela o que um agente lê do modelo — elementos, campanhas, lacunas e ferramentas; a API; e o MCP, o protocolo aberto que conecta assistentes a ferramentas. A leitura é determinística e viaja com prova: um selo de integridade (o proofStamp, uma impressão digital SHA-256) e uma árvore de conferência (Merkle), que prova que um item não foi trocado sem reenviar o conjunto inteiro.
Duas travas importam:
- O MCP hospedado hoje é somente leitura: entrega estado, não aceita comando.
- Escrita exige aprovação em duas pontas — quem opera o agente e quem responde pelo modelo precisam concordar.
E o limite que não é promessa: atuação direta em sensores e válvulas em tempo real é Visão — ainda não disponível.
O caminho mais curto para ver isso funcionando é o tour interativo dos alvos do aprendizado por reforço.
Os alvos: onde a recompensa é calculada
ECBT Score: o saldo, com a incerteza dentro do número
O ECBT Score compara o valor ambiental existente com o custo de resolver o passivo e devolve um saldo em reais, ao lado do ECBT %, a proporção entre os dois lados. O número grande é o saldo; a faixa em volta é a incerteza.
A largura da faixa depende da confiança nos dados, resumida em κ (a letra grega kappa): quanto menor o κ, mais larga a faixa, que pode chegar ao triplo da largura. É o que impede um ganho frágil de ser lido como ganho certo. Veja no painel do ECBT Score. E lembre: é indicador de simulação, não laudo.
EIS: a nota de integridade da evidência, de 0 a 5
O EIS dá nota de 0 a 5 para a evidência, olhando cobertura (quanto foi medido), método (se a coleta seguiu procedimento reconhecido), auditoria (se alguém independente conferiu) e rastro (se dá para reconstruir de onde veio cada número).
É ele que define o κ: κ = EIS ÷ 5. EIS 5 dá κ = 1, confiança máxima; EIS 2,5 dá κ = 0,5, e a faixa do ECBT Score abre. O painel do EIS mostra o anel da nota e a contribuição de cada critério.
A Calculadora como alvo opcional
Quando a meta não é dinheiro nem nota geral, a Calculadora monta o alvo sob medida: média de um parâmetro, razão entre dois parâmetros ou regra contra limite legal — por exemplo, quantos poços ficaram acima do Valor de Investigação. Itens prontos, como o ECBT Score, aparecem na mesma lista.
A regra contra limite legal serve quando a meta é "nada acima do limite": aí o ganho parcial interessa menos que a trava. A razão entre parâmetros serve quando importa a proporção, não o valor absoluto.
A ação testada antes: o comparador de cenários
Um agente precisa de ação com efeito visível. No comparador de cenários, a Base fica fixa, cada cenário muda uma hipótese e o app recusa combinação fisicamente impossível, como rendimento maior que a recuperação. O efeito aparece no ECBT Score e nos ODS. E o aviso continua valendo: simulação não é medição.
Por que ECBT Score e EIS juntos fecham o atalho
Se a recompensa for só dinheiro, o caminho mais curto é cortar custo — e o custo mais fácil de cortar é monitoramento. O agente "aprende" a reduzir campanhas, o saldo melhora no papel e o passivo continua lá, com menos evidência em cima. É a recompensa de eixo único: o algoritmo otimiza o número que você deu, não a intenção que você tinha.
Duas coisas quebram o atalho:
- O EIS entra na recompensa. Cortar campanha derruba a cobertura, e a nota cai.
- O κ cai junto. A faixa do ECBT Score abre, e o ganho deixa de ser certo.
Sobra uma recompensa de dois eixos: saldo e confiança. O agente só ganha quando ganha nos dois. Quem define o alvo define o comportamento.
Treinar um modelo substituto rápido dentro do app
Rodar o motor completo milhares de vezes é caro. A saída é o modelo substituto (surrogate): uma rede pequena que imita a saída do motor com erro conhecido, varre o espaço de combinações em segundos e deixa os pontos interessantes para confirmação no motor completo.
O ecbyts faz isso no ML Studio, no próprio navegador, sem servidor e sem Python. Você escolhe entradas e saída; as variáveis calculadas — EIS, ECBT Score e itens da Calculadora — entram como entrada ou saída, o que permite usar o indicador como alvo de treino.
Três cuidados: a rede estima, não mede; fora da faixa dos dados de treino a estimativa é chute com aparência de número; e modelo substituto acelera a busca, mas não decide. Nenhuma rede neural ou política aprendida altera dado medido ou assina no lugar do Responsável Técnico — o Selo ECBYTS separa na tela o que é máquina do que tem ART e atestado humano.
Limites honestos
- Simulação não é medição. Onde não há medição, há estimativa declarada.
- Dado de demonstração é fictício. Os números do tour não descrevem terreno real.
- Sensores e válvulas em tempo real: Visão — ainda não disponível.
- MCP hospedado: leitura; escrita passa por aprovação em duas pontas.
- Indicador não é laudo. Nem substitui parecer de órgão ambiental ou ART.
- O ambiente tem os limites do dado que recebeu. Campanha faltante é lacuna visível, nunca zero.
Conclusão
O gargalo do aprendizado por reforço em meio ambiente nunca foi a matemática. Foi a ausência de um lugar onde errar é barato e onde a consequência aparece como número comparável. O ecbyts entrega esse lugar: estado legível por agente, ação testada em cenário e recompensa em dois eixos que se vigiam.
O algoritmo você escolhe. A recompensa, você responde.
Comece pelo tour interativo dos alvos e leve uma pergunta para o primeiro cenário: qual atalho o seu agente encontra antes de encontrar a solução?