 ecbyts
Como o ecbyts desenvolve o modelo de linguagem próprio ECBT
Leitura estimada: 6 min
- Guia
- Áudio
Com núcleo em PyTorch e dupla trilha determinística, o modelo compacto ECBT une raciocínio linguístico, cálculo exato em ferramentas e controle de lacunas sem inventar dados.
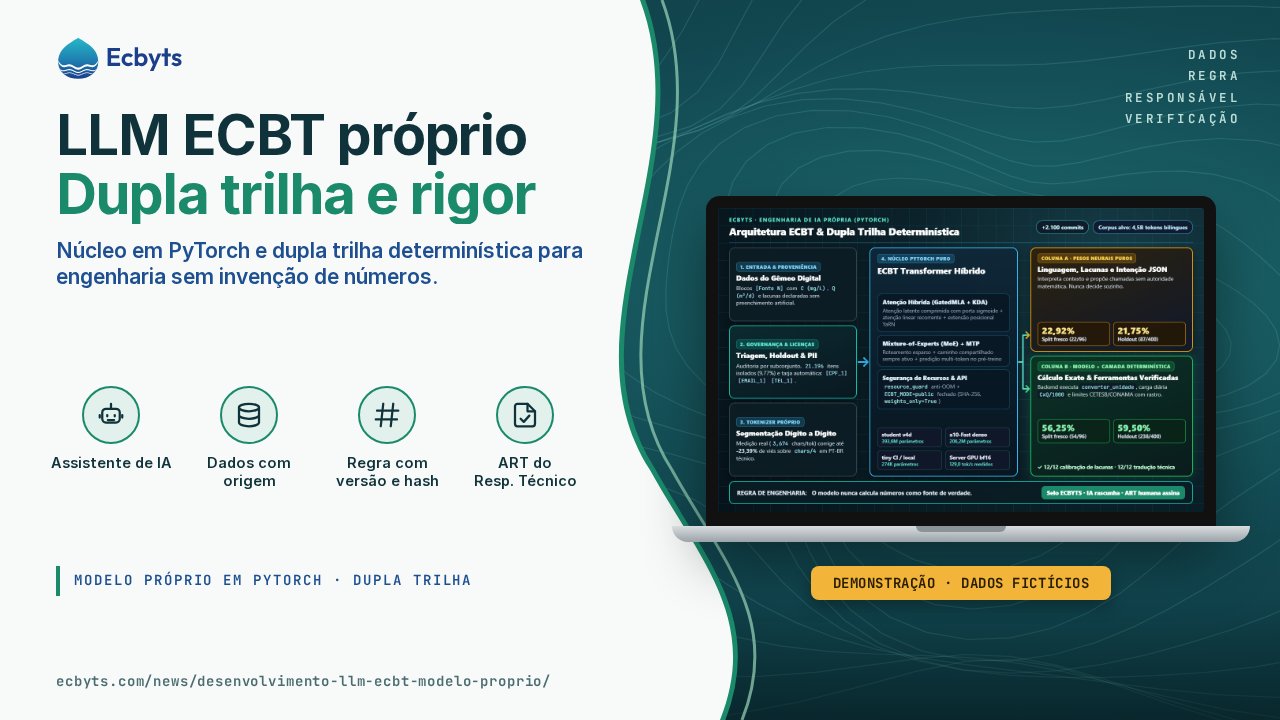
Modelos de linguagem genéricos redigem texto fluido, mas falham em três pontos críticos na engenharia ambiental: inventam valores intermediários ao tentar calcular massa ou diluição, ignoram lacunas de amostragem e exigem o envio de dados sensíveis do cliente para servidores externos. Para resolver essa lacuna na raiz, o projeto mantém desde julho de 2026 o desenvolvimento próprio do ECBT, um modelo de linguagem construído em PyTorch com foco específico em gêmeos digitais, hidrogeologia e conformidade operacional.
Por que criar um modelo próprio para dados ambientais
Quando uma consultoria ou equipe industrial consulta séries históricas com milhares de poços, campanhas laboratoriais e parâmetros químicos em miligramas por litro e metros cúbicos por dia, um assistente comercial comum mistura unidades e preenche vazios estatísticos por probabilidade textual. Sem rastreabilidade entre cada trecho citado e a medição original, qualquer número gerado perde validade técnica.
Há também o limite físico de escala e governança. Modelos abertos gigantes demandam múltiplos aceleradores em nuvem, enquanto notebooks e estações comuns trabalham com pouca memória de vídeo. Além disso, o controle sobre licenças de corpus, proteção contra vazamento de dados pessoais e transparência de avaliação exige domínio completo desde o tokenizador até o servidor de inferência.
Como o ecbyts resolve
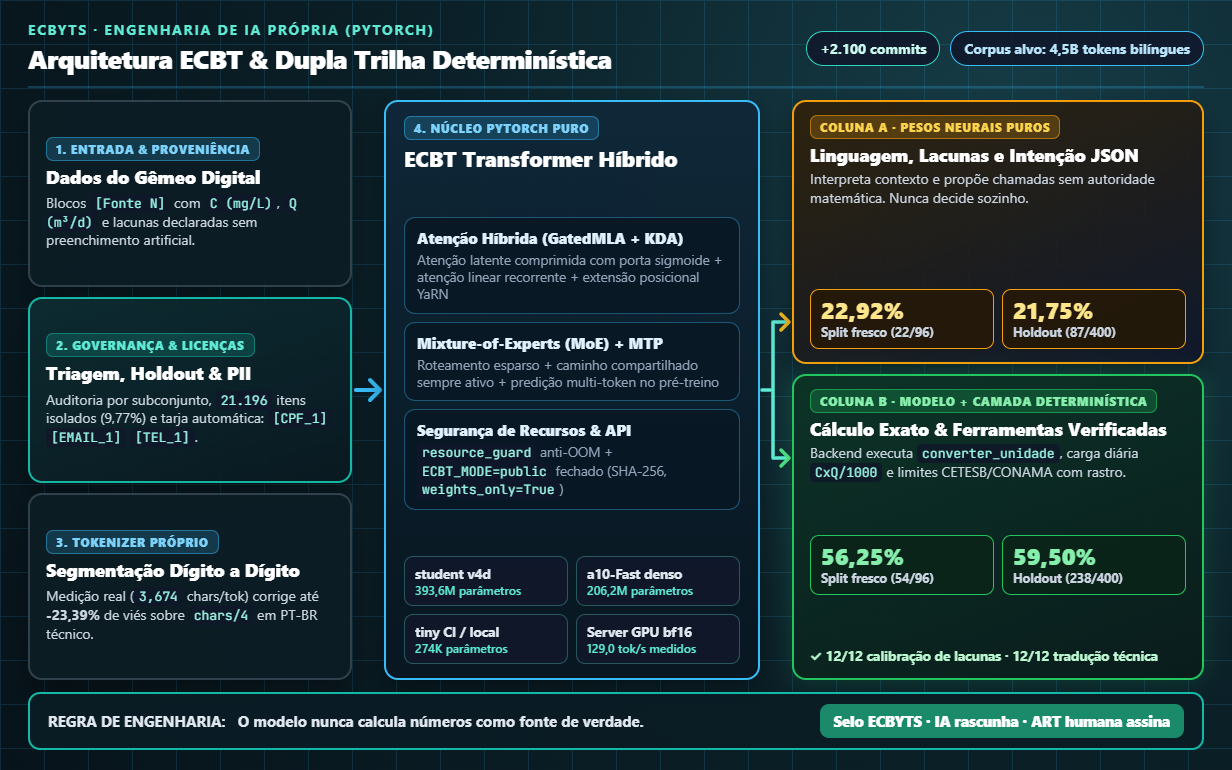
O repositório dedicado do ECBT, com mais de 2.100 commits de engenharia, investiga módulos de atenção híbrida, combinando atenção latente comprimida (GatedMLA) e atenção linear recorrente (KDA) com roteamento esparso Mixture-of-Experts (MoE), extensão posicional YaRN e predição multi-token (MTP). Na linha voltada ao produto, o ecbyts concentrou esforços em arquiteturas compactas e auditáveis, como o modelo `student` de cerca de 394 milhões de parâmetros e a trilha densa de 206,2 milhões de parâmetros, além de um perfil mínimo `tiny` de 274 mil parâmetros usado para testes contínuos de qualidade.
A principal decisão arquitetônica é a Dupla Trilha, que separa o peso neural (Coluna A) da camada determinística de sistema (Coluna B). O modelo de linguagem interpreta a intenção, lê blocos estruturados no formato `[Fonte N]` com concentrações e vazões declaradas, identifica lacunas ausentes e propõe chamadas JSON padronizadas. Quem executa conversão de unidades, cálculo de carga mássica diária e comparação contra valores orientadores legais é o código determinístico do backend. No desenho do ECBT, o modelo nunca calcula número como fonte de verdade.
Toda a base passa por triagem rigorosa antes do treino. A medição direta com o tokenizador próprio provou que a regra ingênua de dividir caracteres por 4 subestima textos técnicos em português em até 23,39% (média medida de 3,674 caracteres por token no corpus misto e 3,064 em documentação técnica em português), levando à adoção de segmentação dígito a dígito para preservar medidas numéricas. Cada fonte passa por auditoria de licença subconjunto a subconjunto, isolamento de 21.196 itens de validação sem vazamento e mascaramento automático de identificadores pessoais (`[CPF_1]`, `[EMAIL_1]`, `[TEL_1]`) antes de qualquer chamada externa ou geração.
Na prática
Em 16 de novembro de 2026, após corrigir um deslocamento de dois passos nos rótulos de treino e remover gabaritos repetitivos de ajuste, a trilha densa do zero de 206,16 milhões de parâmetros concluiu uma sonda de pré-treino de 4.850 passos (1,271 bilhão de tokens). A perda medida em bits por byte (BPB) caiu de forma consistente de 2,8395 no início para 1,7229 em 500 milhões, 1,6142 em 1 bilhão e 1,4871 em 1,271 bilhão de tokens, comprovando aprendizado linguístico real, enquanto o corte rigoroso sem ajuste fino (3 exemplos de contexto) marcou apenas 0,25% (1 acerto em 400) por laços de repetição comuns antes da faixa de 3 a 4 bilhões de tokens.
Com base nessa medição aberta, o pipeline autônomo de curadoria bilíngue (português e inglês) segue expandindo o corpus educacional de 1,8 bilhão para 4,5 bilhões de tokens (somando 2,7 bilhões de novos tokens filtrados com conferência por resumo criptográfico SHA-256 e trava de recursos `resource_guard`), preparando o pré-treino completo e um ajuste fino diverso com 6.000 exemplos.
Os ganhos da Dupla Trilha foram medidos em avaliação controlada sobre o checkpoint `v4d` de 393,6 milhões de parâmetros. Em 400 itens do conjunto de validação isolado, os pesos puros atingiram 21,75% de acerto (ante 9,0% da linha de base), enquanto o sistema completo com camada determinística alcançou 59,50% (238 de 400). Num corte inédito de 96 itens distribuídos em oito categorias, os pesos puros (Coluna A) marcaram 22,92% (declaradamente abaixo da meta autônoma de 35%), ao passo que a integração determinística (Coluna B) elevou a taxa para 56,25%, atingindo 12 de 12 itens na calibração explícita de lacunas, 11 de 12 na estruturação de chamadas agênticas e 12 de 12 em tradução técnica.
No plano de operação segura, o modo público de inferência falha fechado caso falte credencial, armazena chaves apenas como hash SHA-256, bloqueia políticas abertas de origem e carrega pesos com proteção contra código arbitrário. Em hardware dedicado de servidor (`bf16`), o runtime do produto mediu 129,0 tokens por segundo em decodificação sob contrato formal de hardware.
O que este recurso não é
- A trilha do zero de 206,2 milhões de parâmetros ainda está em estágio inicial: na sonda de 1,271 bilhão de tokens o BPB caiu para 1,4871, mas o teste limpo de 3 exemplos ficou em 0,25% (frente à meta de 28% e BPB até 1,14) por repetições em sequência; por isso não há chat sequencial aberto publicado antes do ciclo de 4,5 bilhões de tokens e ajuste fino.
- Pesos neurais isolados (22,92% no corte inédito) não são usados sozinhos para decisões de engenharia: a confiabilidade medida depende integralmente da camada determinística e dos dados estruturados.
- Nenhuma saída do modelo realiza amostragem, substitui laudo laboratorial acreditado, valida atendimento legal ou assina documentos técnicos, atribuições mantidas sob controle humano pelo Selo ECBYTS.
- Velocidades medidas em laboratório (129,0 tokens por segundo em GPU dedicada) valem apenas para o contrato específico de precisão e placa avaliados, não se estendendo a notebooks comuns de 4 GB de memória de vídeo.
Como praticar
Para entender como a camada determinística ancora a inteligência artificial na plataforma, leia as matérias sobre gêmeo digital determinístico e IA e o Selo ECBYTS na entrega assistida por IA. Conheça o ambiente completo no ecbyts ou fale com a engenharia pelo canal de contato.