 ecbyts
Så utvecklar ecbyts den egna språkmodellen ECBT
Lästid: cirka 4 min
- Guide
- Ljud
Med PyTorch-kärna och deterministiskt dubbelspår skiljer den kompakta modellen ECBT på språkstöd, exakt verktygsberäkning och dataluckor utan påhitt.
Allmänna språkmodeller skriver välformulerad text men brister på tre kritiska punkter inom miljöteknik: de gissar mellanvärden vid belastningsberäkningar, hoppar över saknade provtagningar och kräver att känslig projektdata skickas externt. Sedan juli 2026 utvecklar ecbyts språkmodellen ECBT direkt i PyTorch för digitala tvillingar och hydrogeologi.
Varför miljöteknik behöver en egen språkmodell
När ingenjörer granskar långa mätserier med koncentrationer i mg/L och flöden i m3/d över dussintals rör blandar standardchattar enheter och fyller tomrum med språklig sannolikhet. Utan fast länk till originalmätningen förlorar varje genererad siffra sin tekniska bärighet.
Hårdvarugränser och datakontroll väger lika tungt. Jättelika öppna modeller kräver flerkorts GPU-kluster medan vanliga arbetsdatorer har begränsat grafikminne. Egna pipelines krävs också för licensgranskning, avidentifiering av personuppgifter och läckagefria tester.
Så löser ecbyts det
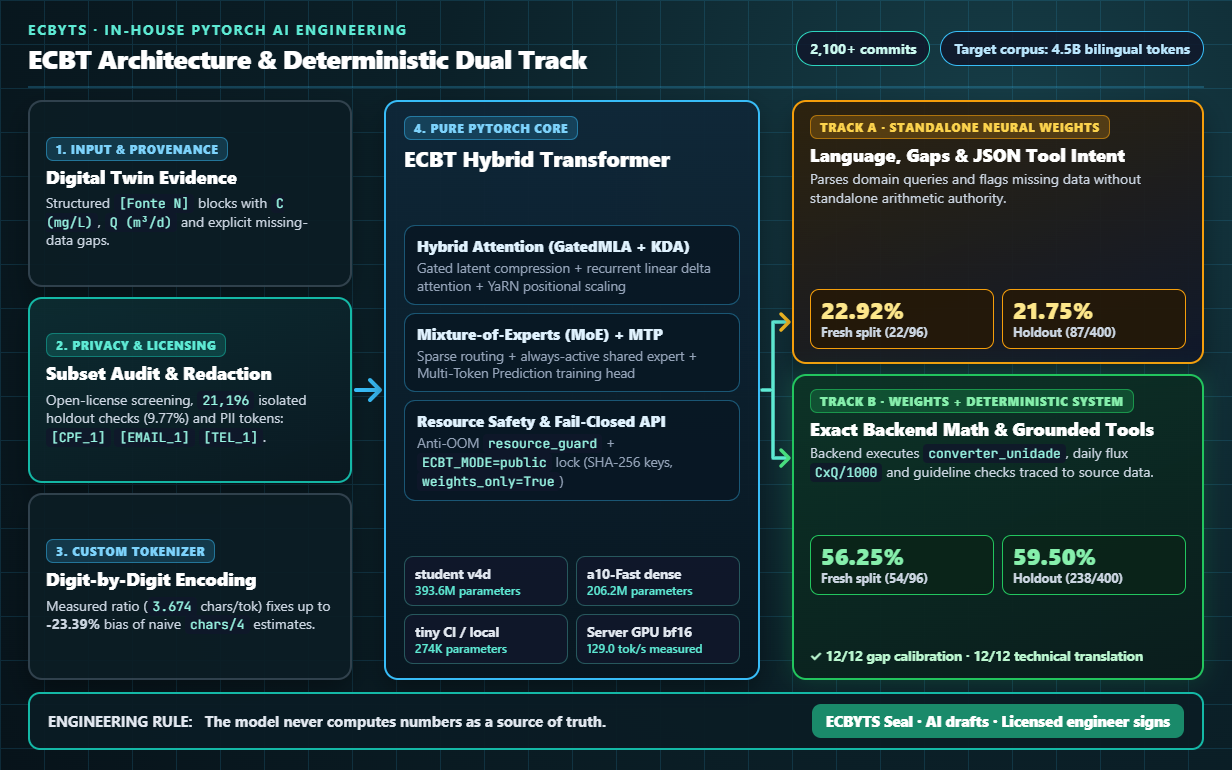
Över 2 100 kodcommit i ECBT utforskar hybrid uppmärksamhet (GatedMLA och linjär KDA) kombinerad med Mixture-of-Experts (MoE), YaRN-skalning och multi-token-prediktion (MTP). Produktarbetet prioriterar kompakta modeller som `student` (~394M parametrar), ett tätt 206,2M-spår och en 274K `tiny`-profil för kontinuerliga tester.
Kärnan är ett Dubbelspår som skiljer neurala vikter (Spår A) från ett deterministiskt systemlager (Spår B). Modellen tolkar syfte, läser strukturerade `[Fonte N]`-block, flaggar uttalade luckor och föreslår JSON-anrop. Enhetsomvandling, dygnsmassa (`C x Q / 1000`) och gränsvärdeskontroll körs enbart i deterministisk kod: modellen räknar aldrig som sanningskälla.
Direktmätning på egen tokenizer visade att `tecken/4` underskattar teknisk text med upp till 23,39%, vilket ledde till entalsuppdelning av siffror. Varje delmängd granskas per licens, 21 196 testfall hålls åtskilda (9,77%) och persondata ersätts automatiskt (`[CPF_1]`, `[EMAIL_1]`, `[TEL_1]`).
I praktiken
Den 16 november 2026, efter att ha rättat en tvåstegsförskjutning av träningsetiketter och rensat repetitiva finjusteringsmallar, slutförde det täta 206,16M-spåret från grunden en förträningsmätning på 4 850 steg (1,271 miljarder tokens). Förlusten i bitar per byte (BPB) sjönk jämnt från 2,8395 vid start till 1,7229 vid 500M, 1,6142 vid 1B och 1,4871 vid 1,271B tokens, vilket visar verklig språkinlärning, medan det rena 3-shot-testet nådde 0,25% (1 av 400) på grund av upprepningsslingor som är vanliga före 3 till 4 miljarder tokens.
Utifrån denna öppna mätning växer det tvåspråkiga urvalet (portugisiska och engelska) från 1,8 till 4,5 miljarder tokens (2,7 miljarder nya tokens med SHA-256-kontroll och minnesskyddet `resource_guard`) inför full förträning och varierad finjustering på 6 000 exempel.
Mätningar på kontrollpunkten `v4d` (393,6M parametrar) visar effekten tydligt. På 400 separata testfall ökade rena vikter från 9,0% till 21,75% (87/400), medan hela Spår B-systemet nådde 59,50% (238/400). På ett nytt delset med 96 fall fick rena vikter 22,92% (under 35%-kravet), medan Spår B nådde 56,25%, med 12/12 i kalibrerade dataluckor och 12/12 i teknisk översättning.
I publikt driftläge vägrar servern starta utan giltig SHA-256-nyckel, blockerar öppet CORS och laddar vikter med `weights_only=True`. På dedikerad server-GPU (`bf16`) uppmättes 129,0 tokens per sekund vid avkodning.
Vad den här funktionen inte är
- Det täta 206,2M-spåret från grunden är fortfarande i tidig skala: vid 1,271 miljarder tokens föll BPB till 1,4871, men rent 3-shot-resultat stannade på 0,25% (under kravet på 28% och BPB 1,14) till följd av upprepningar; ECBT öppnas därför inte som sekventiell chatt före 4,5 miljarder tokens och finjustering.
- Fristående vikter (22,92% i nytt test) används aldrig ensamma utan deterministiska beräkningsverktyg och källblock.
- Ingen modellutdata ersätter fältprovtagning, ackrediterade laboratorierapporter, fysiksimulering eller signering under ECBYTS-sigillet.
- Uppmätta 129,0 tokens/s gäller strikt inom angivet GPU- och `bf16`-kontrakt, inte på bärbara datorer med 4 GB VRAM.
Så övar du
Läs vidare om spårbar AI i deterministisk digital tvilling och AI samt ECBYTS-sigillet i AI-stödda rapporter. Utforska ecbyts eller nå tekniker via kontaktsidan.