 ecbyts
 अपना ECBT भाषा मॉडल कैसे विकसित कर रहा है
अनुमानित पठन समय: 8 मिनट
- गाइड
- ऑडियो
PyTorch और नियतात्मक दोहरे पथ के साथ कॉम्पैक्ट ECBT मॉडल भाषा विश्लेषण, सटीक टूल गणना और डेटा अंतराल को अलग रखता है ताकि कोई संख्या गढ़ी न जाए।
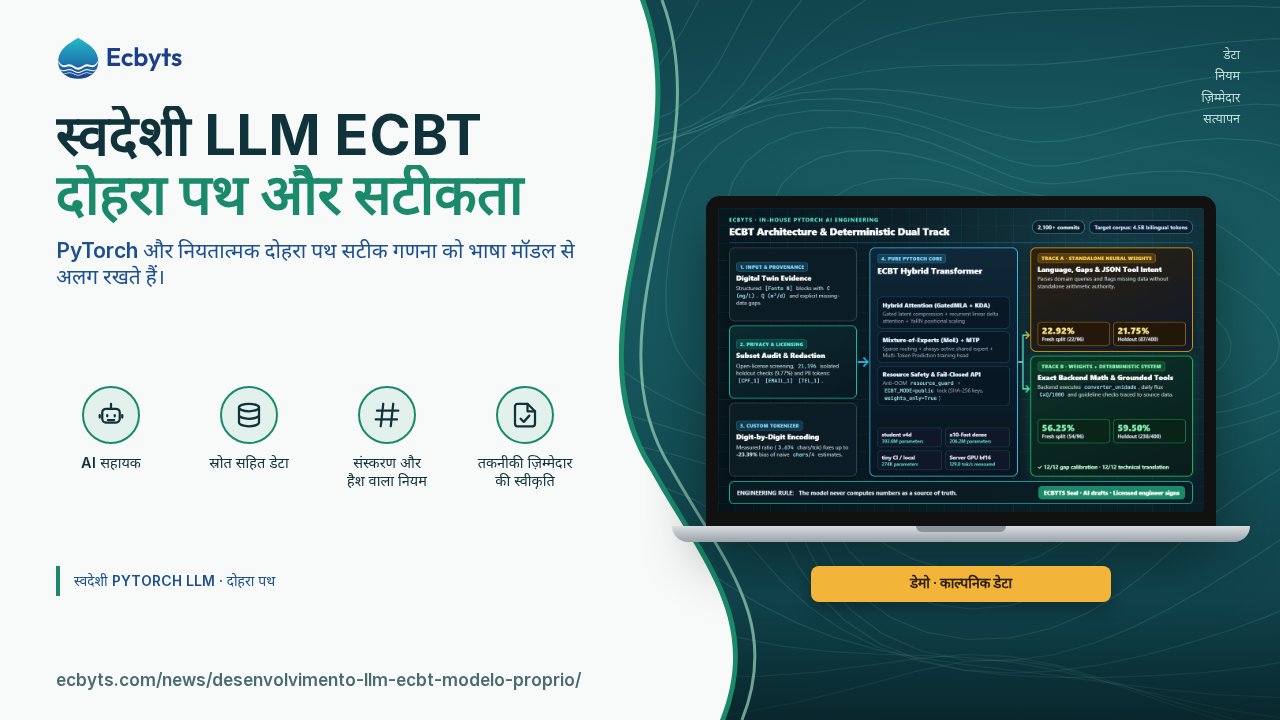
सामान्य भाषा मॉडल सहज वाक्य लिखते हैं लेकिन पर्यावरण इंजीनियरिंग की तीन प्रमुख जरूरतों पर विफल होते हैं: वे भार या तनुकरण की गणना में बीच के आंकड़े अनुमान से भर देते हैं, छूटे हुए नमूना दौर को अनदेखा करते हैं और गोपनीय प्रोजेक्ट डेटा बाहरी सर्वर पर भेजने की मांग करते हैं। जुलाई 2026 से ecbyts डिजिटल ट्विन और जल-भूविज्ञान के लिए शुद्ध PyTorch में ECBT विकसित कर रहा है।
पर्यावरण इंजीनियरिंग के लिए निजी भाषा मॉडल क्यों जरूरी है
जब इंजीनियर दर्जनों कुओं में mg/L सांद्रता और m3/d प्रवाह की लंबी श्रृंखला जांचते हैं, तो सामान्य चैटबॉट इकाइयां मिला देते हैं और डेटा की कमी को पाठ संभावना से भर देते हैं। मूल माप से सीधा जुड़ाव न होने पर कोई भी उत्पन्न अंक तकनीकी आधार खो देता है।
गणना क्षमता और डेटा स्रोत नियंत्रण भी उतने ही अहम हैं। विशाल खुले मॉडल कई क्लाउड GPU मांगते हैं जबकि सामान्य कार्य कंप्यूटर सीमित वीडियो मेमोरी पर चलते हैं। बाहरी API पर निर्भर रहने से प्रशिक्षण लाइसेंस जांच, व्यक्तिगत जानकारी छुपाने और लीक-मुक्त परीक्षण पर नियंत्रण खत्म हो जाता है।
ecbyts इसे कैसे हल करता है
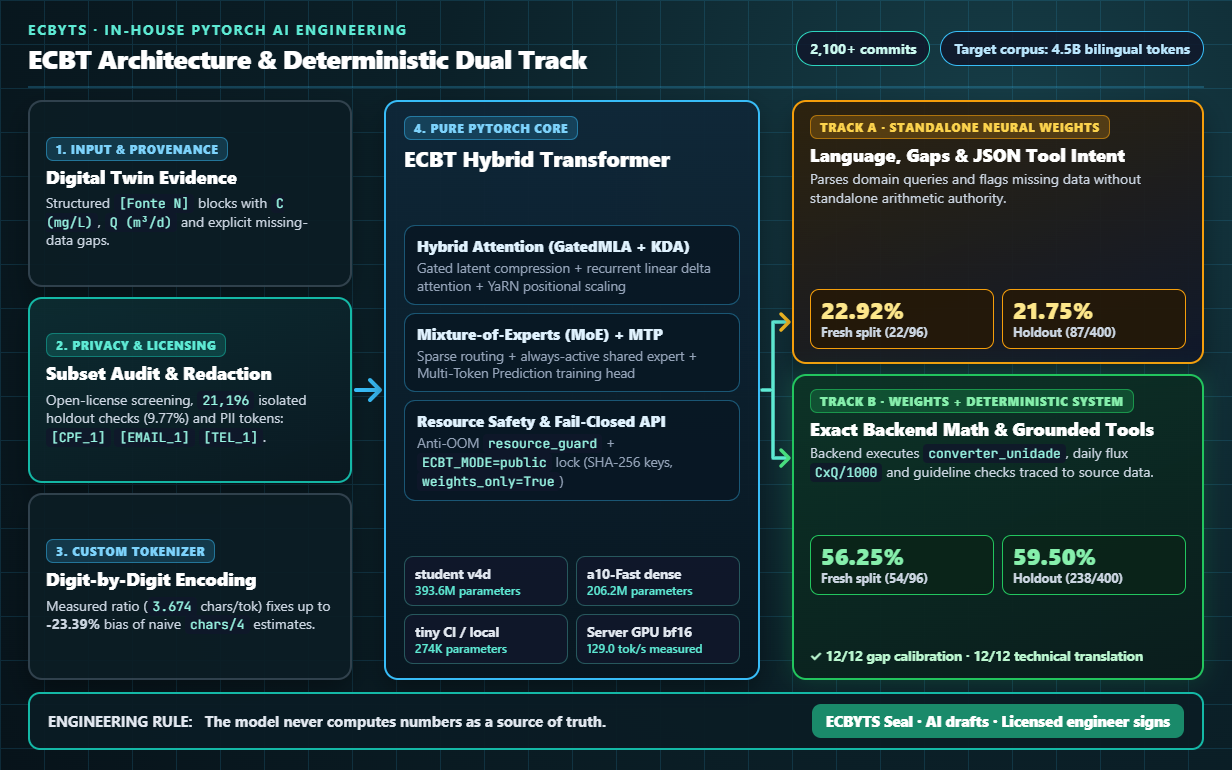
2,100 से अधिक इंजीनियरिंग कमिट्स के साथ ECBT रिपॉजिटरी संकुचित लेटेंट अटेंशन (GatedMLA) और रैखिक पुनरावर्ती अटेंशन (KDA) को MoE रूटिंग, YaRN स्थिति विस्तार और मल्टी-टोकन पूर्वानुमान (MTP) के साथ परखती है। उत्पाद स्तर के लिए लगभग 39.4 करोड़ पैरामीटर वाले `student`, 20.62 करोड़ डेंस मार्ग और निरंतर जांच हेतु 2.74 लाख पैरामीटर `tiny` प्रोफाइल को प्राथमिकता दी गई है।
मुख्य वास्तुकला दोहरा पथ है जो न्यूरल वज़न (कॉलम A) को नियतात्मक सिस्टम परत (कॉलम B) से अलग करती है। मॉडल उद्देश्य समझता है, `[Fonte N]` खंड पढ़ता है, घोषित कमियां दिखाता है और JSON टूल कॉल प्रस्तावित करता है। इकाई रूपांतरण, दैनिक द्रव्यमान भार (`C x Q / 1000`) और नियामक मानक तुलना केवल नियतात्मक बैकएंड कोड चलाता है।
स्वयं के टोकनाइज़र मापन से सिद्ध हुआ कि `अक्षर/4` नियम तकनीकी पुर्तगाली में टोकन संख्या को 23.39% तक कम आंकता है, इसलिए अंकों को अलग-अलग विभाजित किया गया। प्रत्येक उप-डेटासेट लाइसेंस जांच, 21,196 अलग रखे गए परीक्षण मदों (9.77%) और स्वचालित गोपनीय पहचान मास्किंग (`[CPF_1]`, `[EMAIL_1]`, `[TEL_1]`) से गुजरता है।
व्यवहार में
16 नवंबर 2026 को प्रशिक्षण लेबल में दो-चरण के विस्थापन को सुधारने और दोहराव वाले फाइन-ट्यूनिंग सांचों को हटाने के बाद, शून्य से प्रशिक्षित 20.616 करोड़ पैरामीटर वाले सघन मार्ग ने 4,850 चरणों (1.271 अरब टोकन) की जांच पूरी की। बिट्स-प्रति-बाइट (BPB) हानि प्रारंभिक 2.8395 से लगातार घटकर 50 करोड़ पर 1.7229, 1 अरब पर 1.6142 और 1.271 अरब टोकन पर 1.4871 तक पहुंची, जो वास्तविक भाषा सीखने को दिखाती है, जबकि बिना फाइन-ट्यूनिंग वाला 3-शॉट परीक्षण 3 से 4 अरब टोकन से पहले आने वाले दोहराव चक्रों के कारण 0.25% (400 में 1) रहा।
इस खुले मापन के आधार पर द्विभाषी (पुर्तगाली और अंग्रेजी) शैक्षिक डेटा संग्रह 1.8 अरब से 4.5 अरब टोकन (SHA-256 जांच और `resource_guard` सुरक्षा सहित 2.7 अरब नए टोकन) तक विस्तारित हो रहा है, जिसके बाद पूर्ण पूर्व-प्रशिक्षण और 6,000 विविध उदाहरणों पर फाइन-ट्यूनिंग चलेगी।
39.36 करोड़ पैरामीटर `v4d` चेकपॉइंट पर नियंत्रित परीक्षण परिणाम स्पष्ट हैं। 400 पृथक परीक्षण मदों में शुद्ध वज़न 9.0% आधार से बढ़कर 21.75% (87/400) हुए, जबकि नियतात्मक कॉलम B प्रणाली 59.50% (238/400) पर पहुंची। आठ श्रेणियों के 96 नए परीक्षणों में शुद्ध वज़न 22.92% (35% स्वतंत्र लक्ष्य से कम) रहे, पर कॉलम B ने सटीकता 56.25% तक पहुंचा दी और अंतराल अंशांकन व तकनीकी अनुवाद में 12/12 स्कोर हासिल किया।
सार्वजनिक सेवा मोड बिना कुंजी के शुरू नहीं होता, कुंजियां केवल SHA-256 हैश में रखता है, खुले CORS को रोकता है और `weights_only=True` से भार लोड करता है। समर्पित सर्वर GPU (`bf16`) अनुबंध के तहत रनटाइम ने 129.0 टोकन प्रति सेकंड डिकोड गति मापी।
यह सुविधा क्या नहीं है
- शून्य से बना 20.62 करोड़ सघन मार्ग अभी शुरुआती स्तर पर है: 1.271 अरब टोकन पर BPB घटकर 1.4871 हुआ, पर दोहराव चक्रों के कारण 3-शॉट जांच 0.25% (28% और BPB 1.14 लक्ष्य से नीचे) रही, इसलिए 4.5 अरब टोकन और फाइन-ट्यूनिंग पूरे होने से पहले खुला अनुक्रमिक चैट शुरू नहीं किया गया है।
- केवल मॉडल वज़न (नए कट में 22.92%) को नियतात्मक गणना और स्रोत उद्धरण परत के बिना स्वतंत्र रूप से उपयोग नहीं किया जाता।
- कोई भी आउटपुट क्षेत्र नमूनाकरण, मान्यता प्राप्त प्रयोगशाला रिपोर्ट, भौतिक सिमुलेशन या ECBYTS मुहर के अंतर्गत अधिकृत अभियंता के हस्ताक्षर का स्थान नहीं लेता।
- मापी गई 129.0 टोकन/सेकंड गति केवल घोषित समर्पित GPU और `bf16` अनुबंध में मान्य है, 4 GB VRAM वाले सामान्य लैपटॉप पर नहीं।
अभ्यास कैसे करें
नियतात्मक प्रणाली और AI के जुड़ाव को समझने के लिए नियतात्मक डिजिटल ट्विन और AI तथा AI रिपोर्ट के लिए ECBYTS मुहर पढ़ें। ecbyts देखें या संपर्क पृष्ठ से जुड़ें।