 ecbyts
Comment ecbyts développe son propre modèle de langage ECBT
Lecture estimée : 5 min
- Guide
- Audio
Conçu en PyTorch avec une double voie déterministe, le modèle compact ECBT sépare rédaction technique, calcul exact et lacunes de preuve sans inventer de chiffres.
Les modèles de langage généralistes rédigent avec aisance mais échouent sur trois points en ingénierie environnementale : ils devinent les grandeurs intermédiaires dans un calcul de charge, oublient les campagnes manquantes et imposent l’envoi de données sensibles hors site. Depuis juillet 2026, ecbyts développe ECBT en PyTorch pur pour accompagner les jumeaux numériques et l’hydrogéologie.
Pourquoi développer un modèle interne pour l’ingénierie environnementale
Face à des séries chronologiques mêlant concentrations en mg/L et débits en m3/j sur des dizaines de piézomètres, un assistant standard mélange les bases d’unités et comble les vides par probabilité linguistique. Sans lien direct avec la mesure d’origine, tout chiffre généré perd sa valeur technique.
La charge matérielle et la traçabilité pèsent tout autant. Les grands modèles ouverts exigent plusieurs GPU cloud alors que les postes courants ont peu de mémoire vidéo. Sans maîtrise complète du tokeniseur aux poids, il est impossible d’auditer chaque licence ni d’éviter la fuite de données de test.
Comment ecbyts y répond
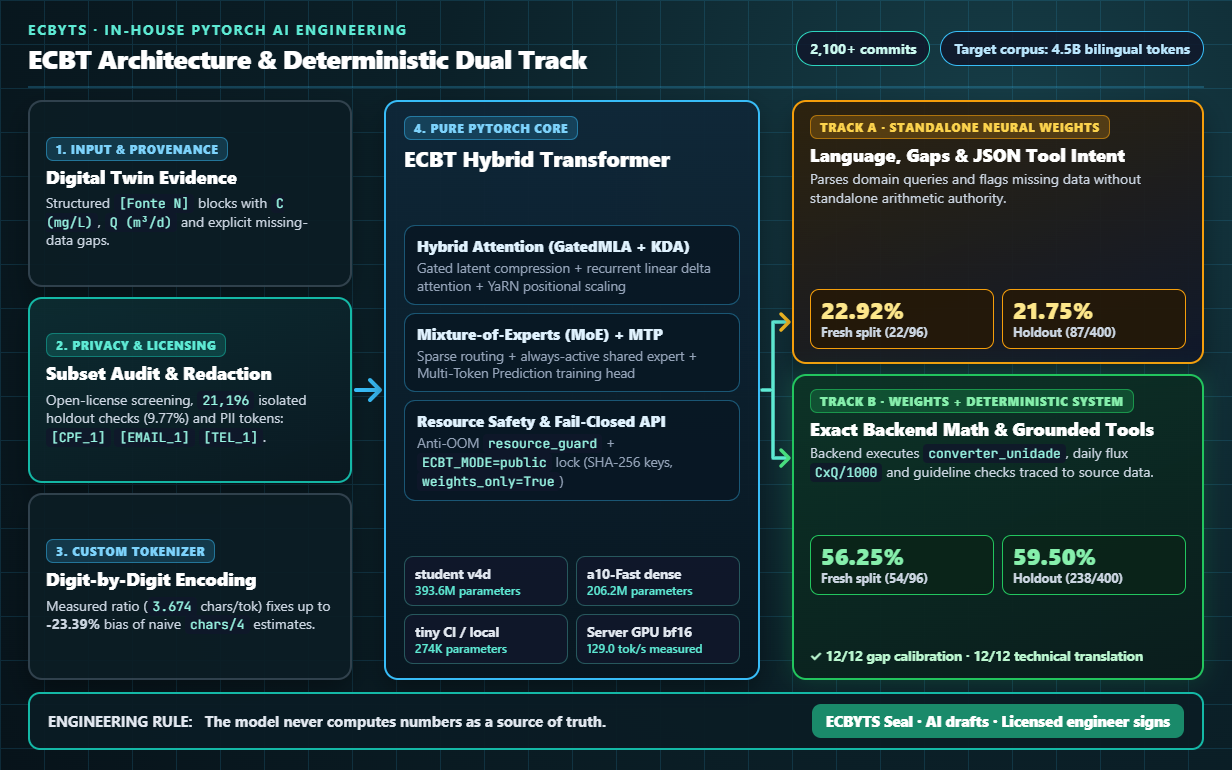
Au fil de plus de 2.100 commits, le dépôt ECBT explore l’attention hybride (GatedMLA compressée et attention linéaire récurrente KDA) associée au routage Mixture-of-Experts (MoE), au positionnement YaRN et à la prédiction multi-token (MTP). Pour l’usage produit, l’ingénierie privilégie des profils compacts : un modèle `student` de ~394 millions de paramètres, une piste dense de 206,2 millions et un profil `tiny` de 274K pour les tests continus.
L’architecture repose sur la Double Voie séparant les poids neuronaux (Colonne A) de la couche système déterministe (Colonne B). Le modèle analyse l’intention, lit des blocs structurés `[Fonte N]`, signale les manques explicites et propose des appels JSON typés. Le backend déterministe calcule conversions d’unités, flux massiques (`C x Q / 1000`) et seuils réglementaires : le modèle ne calcule jamais comme source de vérité.
Des mesures réelles du tokeniseur ont montré que l’approximation naïve `caractères / 4` sous-estime les documents techniques en portugais jusqu’à 23,39%, conduisant à segmenter les chiffres individuellement. Chaque sous-ensemble suit un contrôle de licence, 21.196 éléments de validation isolés (9,77%) et un masquage automatique des identifiants (`[CPF_1]`, `[EMAIL_1]`, `[TEL_1]`).
En pratique
Le 16 novembre 2026, après correction d’un décalage de deux pas sur les étiquettes d’entraînement et suppression de gabarits répétitifs d’ajustement, la piste dense de 206,16 millions de paramètres entraînée de zéro a achevé une sonde de 4.850 pas sur 1,271 milliard de tokens. La métrique bits par octet (BPB) a baissé régulièrement de 2,8395 au départ à 1,7229 à 500M, 1,6142 à 1B et 1,4871 à 1,271B tokens, prouvant un réel apprentissage, tandis que le test propre à 3 exemples sans ajustement est resté à 0,25% (1/400) en raison de boucles répétitives fréquentes sous 3 à 4 milliards de tokens.
À la lumière de cette mesure ouverte, la curation bilingue (portugais et anglais) élargit le corpus de 1,8 milliard vers 4,5 milliards de tokens éducatifs (2,7 milliards de nouveaux tokens vérifiés par empreinte SHA-256 et garde mémoire `resource_guard`) avant le pré-entraînement complet et un réglage diversifié de 6.000 exemples.
Sur le checkpoint `v4d` de 393,6 millions de paramètres, la progression est chiffrée : sur 400 cas isolés, les poids seuls passent de 9,0% à 21,75% (87/400), tandis que la Colonne B atteint 59,50% (238/400). Sur un jeu neuf de 96 cas en huit catégories, les poids seuls obtiennent 22,92% (sous le seuil autonome de 35%), mais la double voie atteint 56,25%, dont 12/12 en calibration des lacunes et 12/12 en traduction technique.
Côté sécurité, le mode public refuse de démarrer sans clé SHA-256, bloque les origines ouvertes et charge les tenseurs via `weights_only=True`. Sous contrat matériel dédié en `bf16`, le moteur a mesuré 129,0 tokens par seconde en décodage.
Ce que cette fonctionnalité n’est pas
- La piste dense de 206,2M reste en phase initiale : à 1,271 milliard de tokens le BPB est descendu à 1,4871 mais le test propre à 3 exemples n’atteint que 0,25% (sous le seuil de 28% et BPB 1,14) à cause des répétitions ; ECBT n’est donc pas exposé en chat séquentiel public avant la fin des 4,5 milliards de tokens et du réglage fin.
- Les poids seuls (22,92% sur jeu neuf) ne servent jamais sans la couche déterministe de calcul et de citation.
- Aucune sortie ne remplace l’échantillonnage de terrain, les analyses de laboratoire accréditées, la simulation physique ni la signature humaine portée par le Sceau ECBYTS.
- Les 129,0 tokens/s mesurés valent uniquement dans le contrat GPU et précision `bf16` déclaré, jamais sur un portable limité à 4 Go de VRAM.
Comment pratiquer
Pour approfondir cette approche, consultez jumeau numérique déterministe et IA ainsi que le Sceau ECBYTS pour les rapports assistés par IA. Accédez à ecbyts ou utilisez la page de contact.