 ecbyts
自主语言模型ECBT研发进展
预计阅读:1 分钟
- 指南
- 音频
基于PyTorch与确定性双轨架构,轻量ECBT模型将语义理解、后端精确计算与证据缺口标识严格分离,避免编造数字。
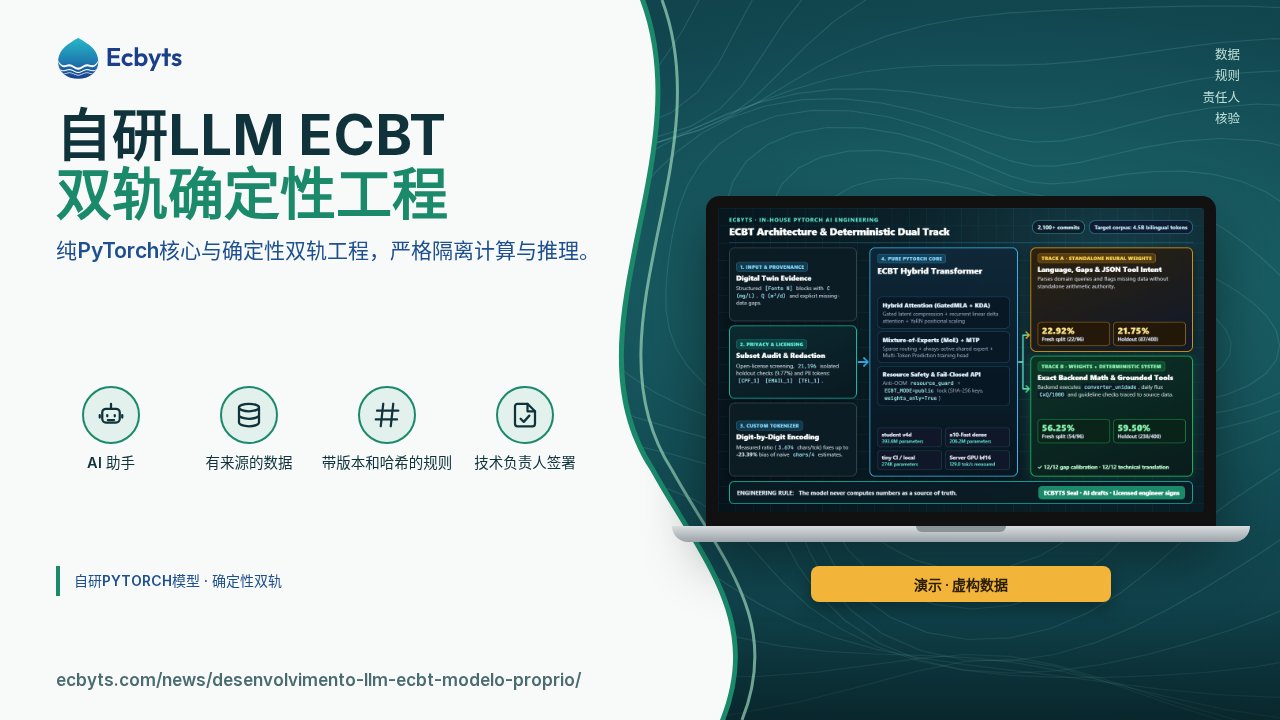
通用大语言模型行文流畅,但在环境工程场景中存在三大短板:在计算污染物负荷或稀释比时凭概率猜测中间数值、忽略缺失的监测批次,以及要求将敏感项目数据上传至外部接口。自2026年7月起,ecbyts依托纯PyTorch自研ECBT语言模型,专门服务数字孪生与水文地质工作流。
为何环境工程需要自主研发语言模型
当工程团队交叉分析几十口监测井多年数据、同时处理mg/L浓度与m3/d流量时,通用助手极易混淆基准单位并用概率语言填补观测空白。一旦无法回溯至原始采样记录,生成数字便失去技术依据。
算力约束与数据溯源同样关键。超大规模开源权重依赖多卡云端集群,无法在常规工作站内存下稳定运行;依赖外部黑盒模型也无法独立审计训练许可、过滤个人身份信息或防范评测数据泄漏。
ecbyts 的解决方式
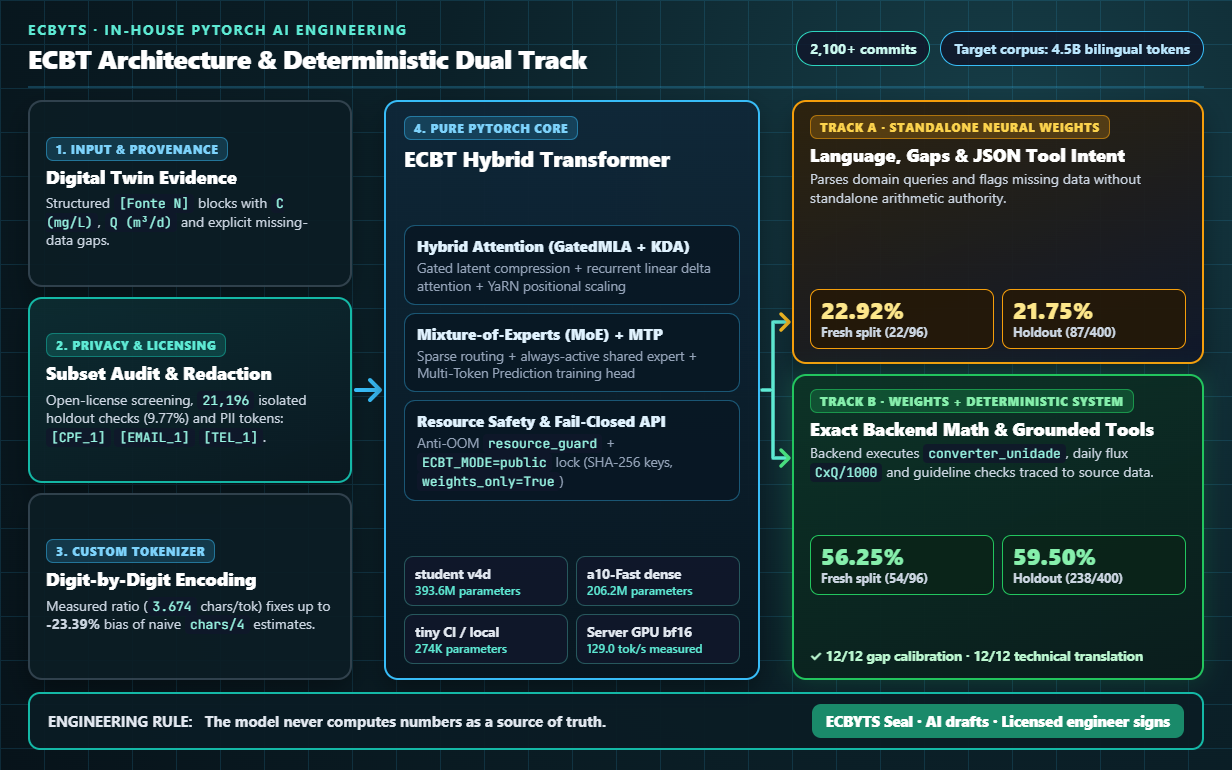
经过超过2100次代码提交,ECBT仓库探索了混合注意力模块,结合压缩潜在注意力(GatedMLA)与线性递归注意(KDA)、混合专家路由(MoE)、YaRN位置扩展及多令牌预测(MTP)。面向产品落地,工程团队聚焦高效率小型分支,包括约3.94亿参数的`student`模型与2.062亿参数稠密路线,以及27.4万参数的`tiny`持续验证配置。
整体设计核心在于双轨架构,将神经权重(A轨)与确定性系统层(B轨)完全解耦。模型负责解析意图、读取结构化`[Fonte N]`证据块、标出已声明缺口并生成规范JSON工具请求;所有单位换算、日通量计算(`C x Q / 1000`)和标准限值比对均由确定性后端执行,模型从不充当算术真值来源。
自研分词器实测表明,简单的“字符除以4”估算会在葡语技术文本上低估多达23.39%的词元消耗,团队因此引入逐位数字切分以保障数值稳定。同时严格落实分集开源许可审查、21196条隔离验证集保护(9.77%)以及个人字段自动脱敏(`[CPF_1]`、`[EMAIL_1]`、`[TEL_1]`)。
实际应用
2026年11月16日,在修复训练标签两步偏移并移除重复性微调模板后,2.0616亿参数从零预训练稠密路线完成了4850步(12.71亿词元)探测训练。每字节比特损失(BPB)由初始2.8395稳步降至5亿词元1.7229、10亿词元1.6142及12.71亿词元1.4871,证明语言建模持续生效,但无微调3-shot测试仅达0.25%(400题对1题),受限于30亿至40亿词元前常见的重复循环。
依据该公开诊断,葡英双语教学语料正从18亿扩至45亿词元(新增27亿筛选词元配SHA-256校验与`resource_guard`内存保护),随后推进全量预训练及6000条多样化微调。
对3.936亿参数`v4d`检查点的受控测试验证了双轨价值:在400题隔离评测中,纯权重准确率由9.0%基线升至21.75%(87/400),接入确定性工具的B轨提升至59.50%(238/400)。在8类96题全新划分集中,纯权重为22.92%(低于35%单模门槛),而B轨达到56.25%,其中证据缺口校准达12/12,技术翻译达12/12。
公开服务模式下,缺少凭据拒绝启动、密钥仅存SHA-256摘要、禁用通配符跨域访问并强制`weights_only=True`加载。在专用单卡GPU(`bf16`)硬件契约下,产品服务端实测解码吞吐达每秒129.0词元。
本功能不涵盖的内容
- 2.062亿从零训练分支仍处早期:尽管12.71亿词元下BPB降至1.4871,但3-shot测试仅为0.25%(未达28%且BPB低于1.14的门槛)且仍现重复循环,因此在45亿词元全训与微调完成前暂不开放连续对话测试界面。
- 纯模型权重(全新测试集22.92%)不会脱离确定性计算与引用系统单独用于工程决策。
- 任何输出都不能替代现场采样、具备资质的实验室报告、机理模拟或ECBYTS印章下的人工技术签署。
- 129.0词元/秒仅在声明的专用GPU与`bf16`契约下成立,不适用于4GB显存消费级笔记本。
如何练习
延伸阅读请查看确定性数字孪生与AI及AI报告中的ECBYTS印章。也可访问ecbyts平台或通过联系页面交流。