 ecbyts
Jak ecbyts tworzy własny model językowy ECBT
Szacowany czas czytania: 4 min
- Przewodnik
- Audio
Kompaktowy model PyTorch ECBT rozdziela w podwójnym torze interpretację tekstu, ścisłe obliczenia narzędzi i luki danych bez wymyślania liczb.
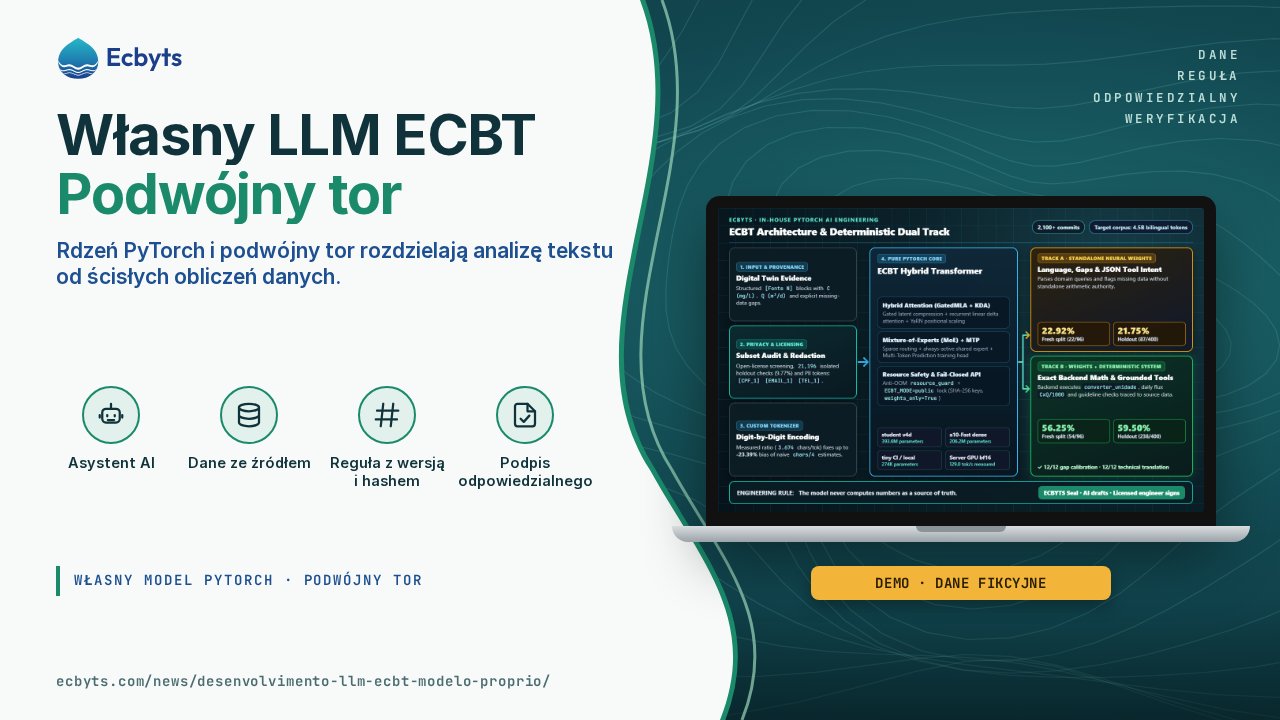
Ogólne modele językowe generują gładkie opisy, ale zawodzą w trzech punktach kluczowych dla inżynierii środowiska: zgadują wartości pośrednie w bilansach masy, pomijają brakujące kampanie pomiarowe i wymagają wysyłania poufnych plików na zewnętrzne serwery. Od lipca 2026 roku ecbyts rozwija w czystym PyTorch własny model ECBT pod bliźniaki cyfrowe i hydrogeologię.
Dlaczego dane środowiskowe potrzebują własnego modelu językowego
Przy analizie wieloletnich serii z dziesiątków otworów łączących mg/L oraz m3/d zwykłe czaty mieszają jednostki i uzupełniają puste miejsca statystycznym prawdopodobieństwem tekstu. Bez bezpośredniego przypięcia do pomiaru każda wygenerowana liczba traci wiarygodność techniczną.
Drugą barierą jest pamięć sprzętu i pochodzenie danych. Wielkie modele otwarte wymagają wieloprocesorowych klastrów GPU, a biurowe stacje mają mało pamięci VRAM. Brak własnego stosu uniemożliwia także audyt licencji danych, maskowanie danych osobowych i ochronę zbioru testowego przed przeciekiem.
Jak ecbyts to rozwiązuje
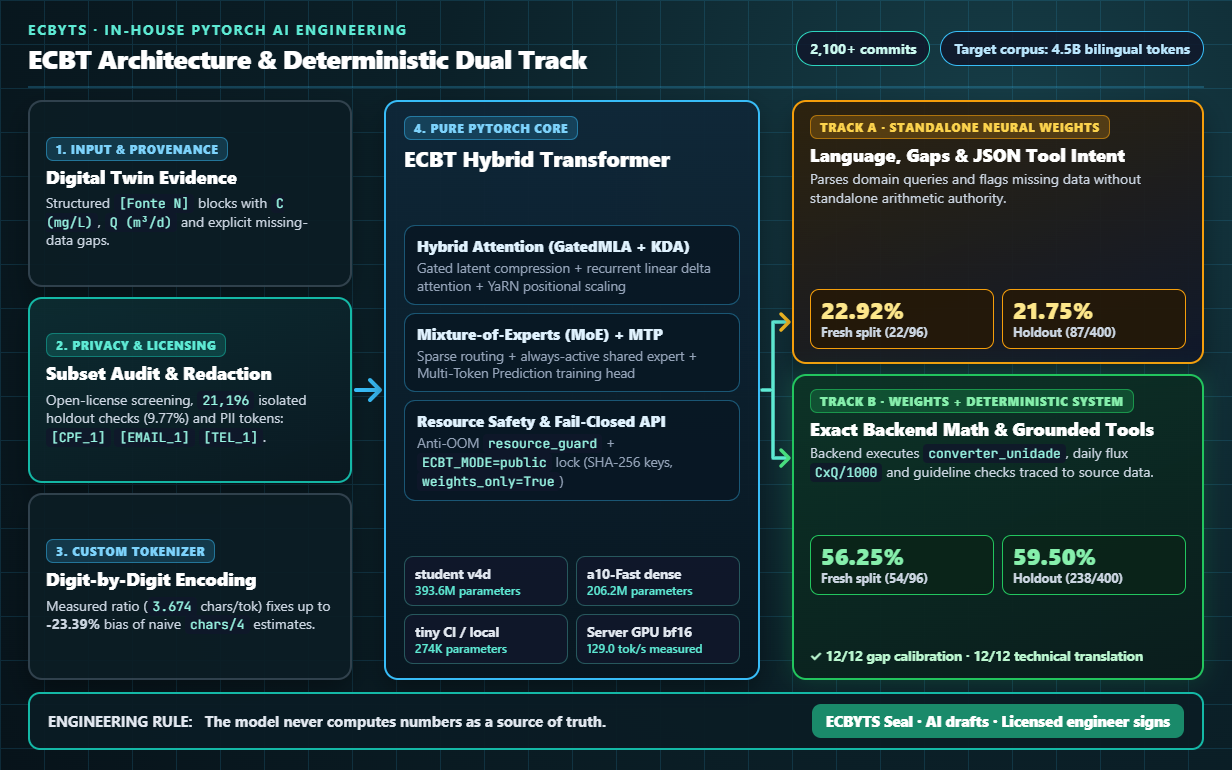
W ponad 2 100 commitach inżynierskich repozytorium ECBT bada architekturę hybrydową łączącą GatedMLA i liniową uwagę rekurencyjną KDA z routingiem Mixture-of-Experts (MoE), skalowaniem YaRN oraz predykcją wielotokenową (MTP). Praktycznie zespół skupił się na kompaktowych wariantach: ~394M modelu `student`, gęstym profilu 206,2M oraz teście `tiny` o skali 274K.
Podstawą jest Podwójny Tor rozdzielający wagi neuronowe (Kolumna A) od deterministycznej warstwy systemowej (Kolumna B). Model rozpoznaje intencję, odczytuje bloki `[Fonte N]`, wskazuje braki i proponuje wywołania JSON. Przeliczanie jednostek, ładunek dobowy (`C x Q / 1000`) i limity prawne liczy wyłącznie deterministyczny backend, dlatego model nigdy nie jest źródłem prawdy rachunkowej.
Pomiary własnym tokenizerem wykazały, że prosta reguła `znaki/4` zaniża objętość techniczną nawet o 23,39%, dlatego wprowadzono dzielenie cyfra po cyfrze. Każdy podzbiór przechodzi kontrolę licencji, izolację 21 196 rekordów testowych (9,77%) oraz automatyczne maskowanie danych (`[CPF_1]`, `[EMAIL_1]`, `[TEL_1]`).
W praktyce
16 listopada 2026 roku, po poprawieniu dwukrokowego przesunięcia etykiet w pętli treningu i usunięciu powtarzalnych szablonów dostrajania, gęsta ścieżka od zera o skali 206,16M parametrów zakończyła sondę 4 850 kroków na 1,271 mld tokenów. Strata BPB spadła stabilnie z 2,8395 na starcie do 1,7229 przy 500M, 1,6142 przy 1B oraz 1,4871 przy 1,271 mld tokenów, dowodząc realnego uczenia języka, natomiast czysty test 3-shot bez dostrojenia uzyskał 0,25% (1/400) z powodu pętli powtórzeń typowych poniżej 3 do 4 mld tokenów.
Na podstawie tej jawnej diagnozy dwujęzyczna kuracja (portugalski i angielski) poszerza zbiór z 1,8 do 4,5 mld tokenów edukacyjnych (2,7 mld nowych tokenów z sumami SHA-256 i ochroną pamięci `resource_guard`) przed pełnym uczeniem wstępnym i zróżnicowanym dostrajaniem na 6 000 przykładów.
Testy na punkcie kontrolnym `v4d` (393,6M parametrów) obrazują zysk podwójnego toru. W zestawie 400 zadań odizolowanych czyste wagi wzrosły z 9,0% do 21,75% (87/400), a pełny system deterministyczny (Kolumna B) osiągnął 59,50% (238/400). Na świeżym podziale 96 zadań czyste wagi dały 22,92% (poniżej celu 35%), lecz Kolumna B podniosła wynik do 56,25%, osiągając 12/12 w kalibracji luk i 12/12 w tłumaczeniu technicznym.
W trybie publicznym serwer nie wstaje bez poświadczeń, zapisuje klucze jako SHA-256, blokuje otwarty CORS i ładuje wagi z `weights_only=True`. Na dedykowanej karcie serwerowej `bf16` środowisko zmierzyło 129,0 tokenów/s podczas dekodowania.
Czym ta funkcja nie jest
- Gęsta ścieżka od zera 206,2M jest we wczesnej skali: przy 1,271 mld tokenów BPB spadło do 1,4871, jednak czysty test 3-shot wyniósł 0,25% (poniżej progu 28% i BPB do 1,14) przez powtórzenia, dlatego do ukończenia cyklu 4,5 mld tokenów i dostrojenia model nie działa jako publiczny czat sekwencyjny.
- Same wagi neuronowe (22,92% na świeżym zestawie) nie pracują samodzielnie bez warstwy deterministycznych narzędzi i źródeł.
- Żadna odpowiedź modelu nie zastępuje poboru prób w terenie, akredytowanych badań laboratoryjnych, symulacji fizycznych ani podpisu osoby uprawnionej pod Pieczęcią ECBYTS.
- Zmierzone 129,0 tokenów/s obowiązują wyłącznie w zadeklarowanym kontrakcie GPU i `bf16`, nie na laptopach z 4 GB VRAM.
Jak ćwiczyć
Więcej o zakotwiczeniu AI w faktach znajdziesz w artykułach deterministyczny bliźniak cyfrowy i AI oraz Pieczęć ECBYTS w raportach AI. Sprawdź ecbyts lub napisz przez stronę kontaktu.