 ecbyts
Cómo ecbyts desarrolla el modelo de lenguaje propio ECBT
Lectura estimada: 5 min
- Guía
- Audio
Con núcleo en PyTorch y doble vía determinística, el modelo compacto ECBT separa redacción técnica, cálculo exacto en herramientas y brechas de evidencia sin inventar cifras.
Los modelos de lenguaje genéricos redactan con soltura, pero fallan en tres exigencias críticas de la ingeniería ambiental: inventan cifras intermedias al intentar calcular cargas o diluciones, ignoran vacíos de muestreo y exigen enviar datos sensibles del proyecto a servidores externos. Desde julio de 2026, ecbyts desarrolla ECBT en PyTorch puro para operar junto a gemelos digitales e hidrogeología auditables.
Por qué desarrollar un modelo propio en ingeniería ambiental
Cuando un equipo técnico consulta series históricas con decenas de pozos y parámetros en mg/L y m3/d, un asistente genérico mezcla escalas y completa huecos por probabilidad lingüística. Sin trazabilidad directa hasta cada lectura medida, cualquier valor generado pierde respaldo profesional.
También pesan el costo de cómputo y la procedencia de datos. Los modelos abiertos masivos exigen clústeres de múltiples GPU, mientras las estaciones de trabajo comunes operan con memoria limitada. Depender de APIs opacas impide auditar licencias de entrenamiento, aislar datos personales y verificar evaluaciones sin filtración de ejemplos.
Cómo lo resuelve ecbyts
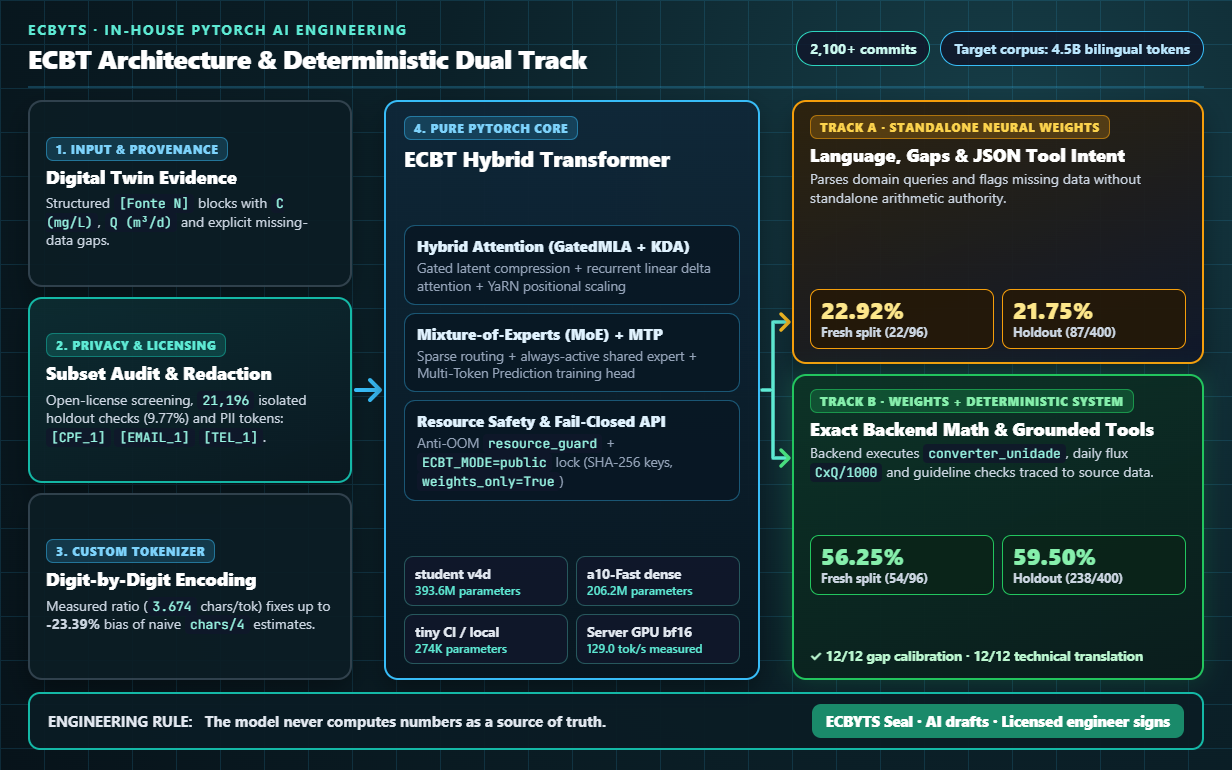
En más de 2.100 commits de ingeniería, el repositorio ECBT investiga atención híbrida (combinando atención latente comprimida GatedMLA y atención lineal recurrente KDA) junto a mezcla de expertos (MoE), escalado posicional YaRN y predicción multitoken (MTP). Para viabilizar operación real, el desarrollo priorizó modelos compactos como `student` (~394 millones de parámetros) y una línea densa de 206,2 millones, junto a un perfil mínimo `tiny` de 274 mil parámetros para pruebas automatizadas.
La decisión central es la Doble Vía, que separa los pesos neuronales (Columna A) de la capa determinística de sistema (Columna B). El modelo interpreta la consulta, lee bloques estructurados `[Fonte N]`, señala brechas declaradas y propone llamadas JSON tipadas. El backend determinístico ejecuta conversiones de unidades, carga másica diaria y comparación normativa: el modelo nunca calcula números como fuente de verdad.
Cada etapa cumple reglas estrictas de procedencia. Mediciones con el tokenizador propio demostraron que estimar `caracteres/4` subestima documentos técnicos en español o portugués (hasta 23,39% de sesgo en portugués técnico), impulsando tokenización dígito por dígito. Además, cada subconjunto supera auditoría de licencia abierta, aislamiento de 21.196 elementos de validación (9,77%) y anonimización automática (`[CPF_1]`, `[EMAIL_1]`, `[TEL_1]`).
En la práctica
El 16 de noviembre de 2026, tras corregir un desplazamiento de dos pasos en etiquetas de entrenamiento y retirar plantillas repetitivas de ajuste, la línea densa desde cero de 206,16 millones de parámetros completó una sonda de 4.850 pasos sobre 1,271 mil millones de tokens. Los bits por byte (BPB) descendieron de forma continua de 2,8395 al inicio a 1,7229 en 500M, 1,6142 en 1B y 1,4871 en 1,271B tokens, demostrando avance real del lenguaje, aunque la prueba limpia de 3 ejemplos sin ajuste marcó 0,25% (1 de 400) por bucles repetitivos habituales debajo de 3 a 4 mil millones de tokens.
Con esa medición abierta como guía, la curaduría bilingüe autónoma (portugués e inglés) amplía el corpus educativo de 1.800 millones hacia 4.500 millones de tokens (sumando 2.700 millones filtrados con verificación SHA-256 y protección de memoria `resource_guard`) antes del preentrenamiento completo y un ajuste fino diverso de 6.000 ejemplos.
Las pruebas controladas sobre el checkpoint `v4d` de 393,6 millones de parámetros muestran el impacto real de la Doble Vía. Sobre 400 ítems de evaluación aislada, los pesos puros subieron de 9,0% a 21,75% (87/400), mientras la integración determinística alcanzó 59,50% (238/400). En una partición inédita de 96 ítems en ocho categorías, los pesos puros (Columna A) obtuvieron 22,92% (por debajo de la meta autónoma de 35%), pero la Columna B elevó la precisión a 56,25%, logrando 12 de 12 en calibración de brechas y 12 de 12 en traducción técnica.
En seguridad y servicio, el modo público falla cerrado si faltan credenciales, guarda claves solo en hash SHA-256, prohíbe orígenes abiertos y carga pesos con `weights_only=True`. Bajo contrato formal en GPU dedicada (`bf16`), el servidor midió 129,0 tokens por segundo en decodificación.
Qué no es este recurso
- La línea densa desde cero de 206,2 millones sigue en escala temprana: aunque su sonda de 1,271 mil millones de tokens bajó el BPB a 1,4871, la prueba limpia de 3 ejemplos quedó en 0,25% (lejos de 28% y BPB hasta 1,14) por bucles de repetición, por lo cual ECBT no opera aún como chat secuencial abierto antes de completar 4,5 mil millones de tokens y ajuste fino.
- Los pesos neuronales aislados (22,92% en partición inédita) no se liberan de forma autónoma sin la capa determinística y las citas de fuente.
- Ninguna salida sustituye campañas de muestreo, ensayos acreditados de laboratorio, simuladores físicos ni la firma de un responsable habilitado bajo el Sello ECBYTS.
- Las métricas de velocidad (129,0 tokens/s) rigen solo dentro del contrato de hardware, precisión y concurrencia evaluado, no en portátiles con 4 GB de VRAM.
Cómo practicar
Profundiza en el uso responsable de IA revisando gemelo digital determinístico e IA y Sello ECBYTS para entregas asistidas por IA. Explora ecbyts o escribe mediante el canal de contacto.