 ecbyts
Come ecbyts sviluppa il modello linguistico proprietario ECBT
Lettura stimata: 5 min
- Guida
- Audio
Sviluppato in PyTorch con doppio percorso deterministico, il modello compatto ECBT separa linguaggio, calcolo esatto su strumenti e lacune senza inventare numeri.
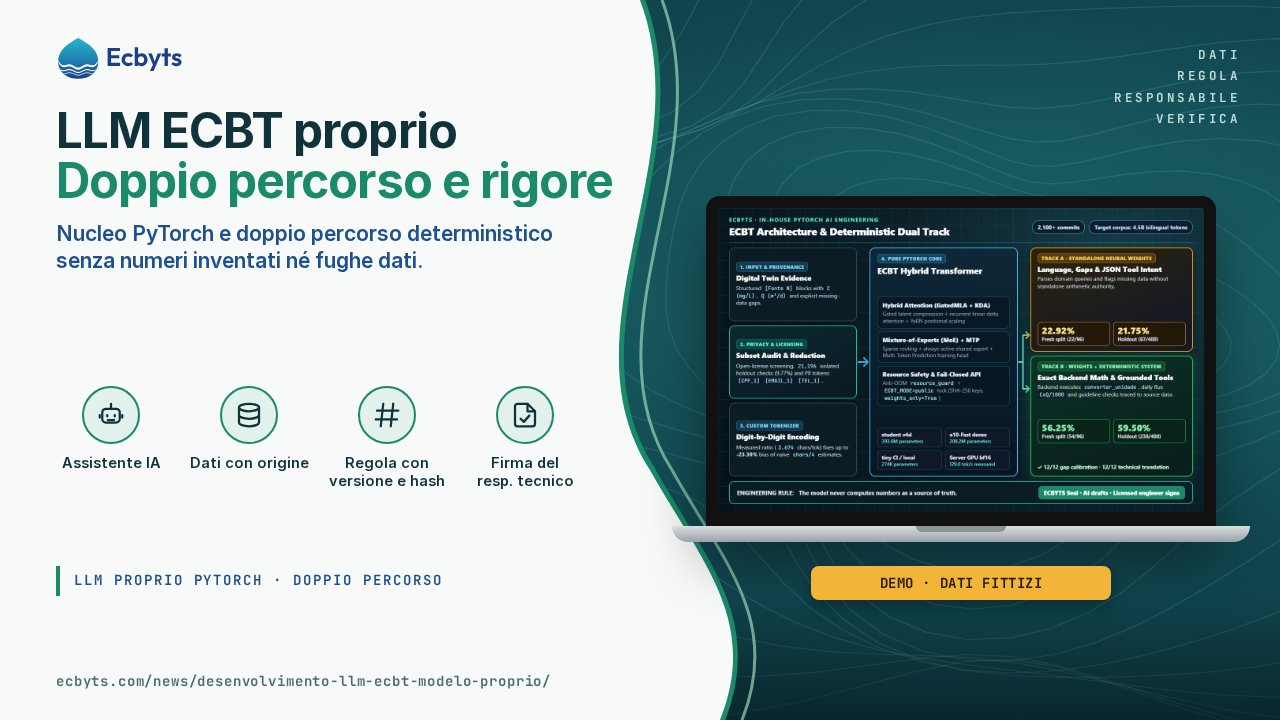
I modelli linguistici generici scrivono testi scorrevoli ma falliscono su tre requisiti essenziali nell’ingegneria ambientale: stimano numeri intermedi nei bilanci di massa, ignorano campagne mancanti e richiedono l’invio di dati riservati verso server esterni. Da luglio 2026 ecbyts sviluppa ECBT in PyTorch puro per lavorare insieme a gemelli digitali e idrogeologia.
Perché creare un modello proprietario per i dati ambientali
Quando i tecnici analizzano serie storiche con decine di piezometri tra concentrazioni in mg/L e portate in m3/d, gli assistenti generici mescolano le unità e riempiono i vuoti statistici per probabilità testuale. Senza collegamento diretto a ogni lettura originale, nessun numero generato regge a una verifica tecnica.
Contano anche il peso computazionale e la provenienza dei dati. I modelli giganti richiedono cluster multi-GPU, mentre i computer comuni hanno memoria video limitata. Senza controllo dal tokenizer al server di inferenza non è possibile verificare le licenze né bloccare perdite di dati di validazione.
Come lo risolve ecbyts
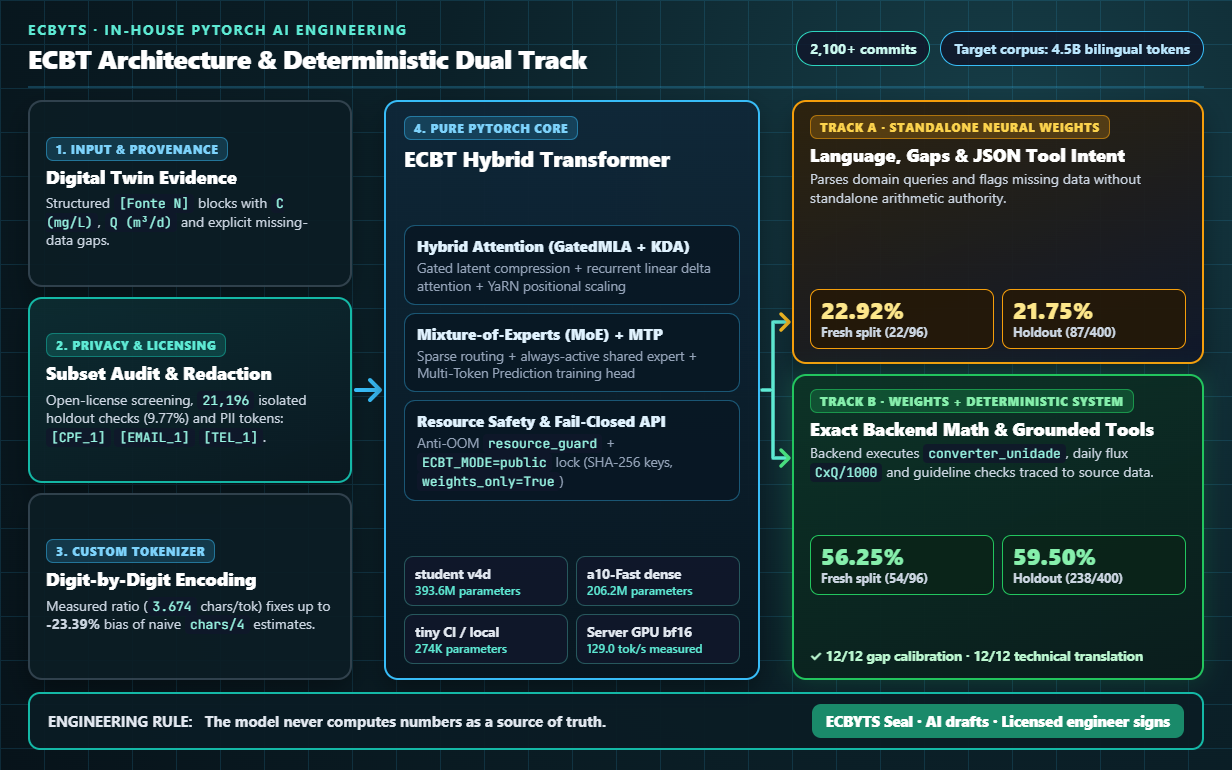
Oltre 2.100 commit di ingegneria esplorano in ECBT blocchi di attenzione ibrida (GatedMLA compressa e attenzione lineare ricorrente KDA) con instradamento Mixture-of-Experts (MoE), estensione YaRN e predizione multi-token (MTP). Per il prodotto reale, il lavoro privilegia architetture compatte: il profilo `student` da ~394 milioni di parametri, una linea densa da 206,2 milioni e un profilo `tiny` da 274K per i test continui.
La scelta chiave è il Doppio Percorso che separa i pesi neurali (Colonna A) dallo strato deterministico di sistema (Colonna B). Il modello legge l’intento e blocchi strutturati `[Fonte N]`, evidenzia lacune esplicite e propone chiamate JSON tipizzate. Il codice deterministico esegue conversioni di unità, carichi giornalieri (`C x Q / 1000`) e confronti normativi: il modello non calcola numeri come fonte di verità.
Le misure sul tokenizer proprio hanno mostrato che la stima `caratteri/4` sottostima i testi tecnici fino al 23,39%, portando alla segmentazione cifra per cifra per preservare i numeri. Ogni sottoinsieme supera verifica di licenza, isolamento di 21.196 elementi di test (9,77%) e oscuramento automatico (`[CPF_1]`, `[EMAIL_1]`, `[TEL_1]`).
In pratica
Il 16 novembre 2026, dopo aver corretto uno slittamento di due passi sulle etichette di addestramento ed eliminato modelli ripetitivi di rifinitura, la linea densa da zero da 206,16 milioni di parametri ha completato una sonda da 4.850 passi su 1,271 miliardi di token. Il valore bits per byte (BPB) è sceso regolarmente da 2,8395 iniziali a 1,7229 a 500M, 1,6142 a 1B e 1,4871 a 1,271 miliardi di token, confermando apprendimento reale, mentre la prova pulita a 3 esempi senza rifinitura si è fermata allo 0,25% (1 su 400) per cicli ripetitivi tipici sotto i 3 o 4 miliardi di token.
Guidata da questa misura trasparente, la curatela bilingue (portoghese e inglese) amplia la base da 1,8 a 4,5 miliardi di token didattici (2,7 miliardi nuovi con verifica SHA-256 e guardia memoria `resource_guard`) prima del pre-addestramento completo e di una rifinitura varia su 6.000 esempi.
I test sul checkpoint `v4d` da 393,6 milioni di parametri quantificano il vantaggio: su 400 casi isolati, i soli pesi salgono dal 9,0% al 21,75% (87/400), mentre il sistema deterministico (Colonna B) sale al 59,50% (238/400). Su 96 casi inediti in otto categorie, i soli pesi ottengono il 22,92% (sotto la soglia autonoma del 35%), mentre la Colonna B raggiunge il 56,25%, con 12/12 nella calibrazione delle lacune e 12/12 nella traduzione tecnica.
In ambito sicurezza, la modalità pubblica non si avvia senza credenziali, conserva solo hash SHA-256, rifiuta CORS aperti e carica pesi con `weights_only=True`. Su GPU server dedicata (`bf16`), il runtime ha misurato 129,0 token al secondo in decodifica.
Cosa non è questa funzione
- La linea densa da 206,2M è ancora in fase iniziale: a 1,271 miliardi di token il BPB scende a 1,4871, ma il test pulito a 3 esempi resta allo 0,25% (sotto la soglia del 28% e BPB 1,14) per cicli ripetitivi; ECBT non è quindi aperto come chat sequenziale prima di completare i 4,5 miliardi di token e la rifinitura.
- I pesi neurali isolati (22,92% sul taglio inedito) non operano mai da soli senza lo strato deterministico e le citazioni alle fonti.
- Nessun output sostituisce il campionamento in campo, i rapporti di laboratorio accreditati, i simulatori fisici o la firma tecnica associata al Sigillo ECBYTS.
- Le velocità misurate (129,0 token/s su GPU dedicata in `bf16`) valgono solo nel contratto hardware dichiarato e non su portatili da 4 GB di VRAM.
Come esercitarsi
Scopri come la parte deterministica sostiene l’intelligenza artificiale negli articoli su gemello digitale deterministico e IA e sul Sigillo ECBYTS nei rapporti con IA. Visita ecbyts o scrivi tramite la pagina contatti.