 ecbyts
Wie ecbyts das eigene Sprachmodell ECBT entwickelt
Lesezeit: etwa 4 Min.
- Leitfaden
- Audio
Das kompakte PyTorch-Modell ECBT trennt über einen deterministischen Doppelpfad Sprachlogik, exakte Werkzeugrechnung und Datenlücken ohne erfundene Zahlen.
Allgemeine Sprachmodelle formulieren flüssige Sätze, scheitern aber in der Umwelttechnik an drei Stellen: Sie schätzen Zwischenwerte bei Frachten oder Verdünnungen, übergehen Messlücken und senden vertrauliche Projektdaten an fremde Server. Seit Juli 2026 entwickelt ecbyts mit ECBT ein eigenes PyTorch-Sprachmodell speziell für digitale Zwillinge und Hydrogeologie.
Warum ein eigenes Modell für Umweltdaten nötig ist
Bei Auswertungen über Dutzende Messstellen mit Einheiten in mg/L und m3/d vermischen Standard-Chatbots Bezugsgrößen und füllen fehlende Kampagnen statistisch auf. Ohne feste Rückbindung an die einzelne Messreihe verliert jede generierte Zahl ihre technische Belastbarkeit.
Hinzu kommen Speicherbedarf und Datenherkunft. Riesige offene Modelle verlangen Cloud-Cluster mit mehreren GPUs, während Arbeitsplatzrechner streng begrenzt sind. Zudem lassen sich Lizenzketten, Datenschutzfilter und saubere Testdaten ohne eigene Pipeline kaum prüfen.
Wie ecbyts das löst
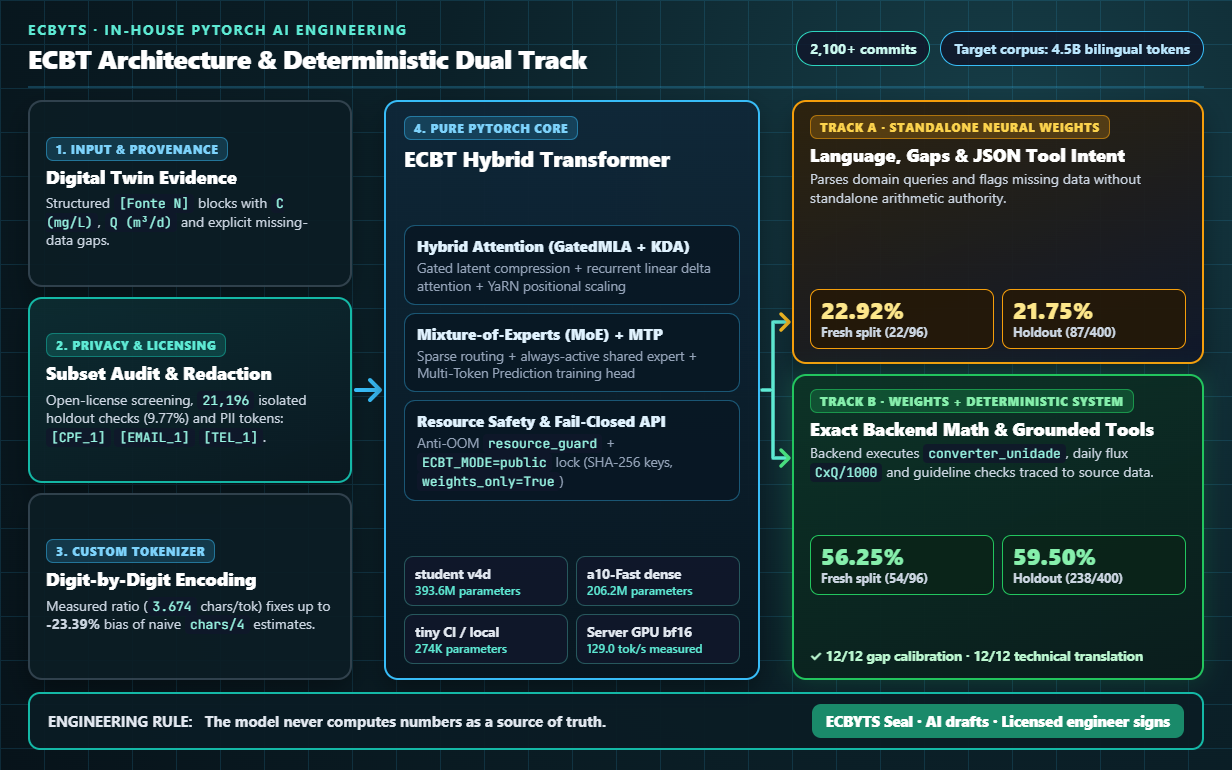
Über mehr als 2.100 Commits erforscht das ECBT-Projekt hybride Aufmerksamkeitsblöcke aus GatedMLA und linearer KDA-Aufmerksamkeit zusammen mit Mixture-of-Experts (MoE), YaRN und Multi-Token Prediction (MTP). Für den produktiven Einsatz priorisiert das Team kompakte Modelle mit 394 Millionen Parametern (`student`) und einen dichten 206,2M-Pfad neben einem 274K-Testprofil.
Kern des Entwurfs ist der Doppelpfad zwischen neuronalen Gewichten (Spalte A) und deterministischer Systemschicht (Spalte B). Das Modell erkennt Absichten, liest `[Fonte N]`-Blöcke, meldet fehlende Nachweise und schlägt strukturierte JSON-Aufrufe vor. Einheitenumrechnung, Tagesfracht (`C x Q / 1000`) und Grenzwertprüfung rechnet ausschließlich deterministischer Backend-Code.
Jeder Trainingslauf folgt strenger Herkunftsprüfung. Eigene Tokenizer-Messungen zeigten, dass naive `Zeichen/4`-Regeln den Tokenbedarf in technischem Portugiesisch um bis zu 23,39% unterschätzen, weshalb Ziffern einzeln tokenisiert werden. Lizenzprüfung je Teilmenge, 21.196 isolierte Testfälle (9,77%) und automatische Schwärzung (`[CPF_1]`, `[EMAIL_1]`, `[TEL_1]`) schützen Daten und Auswertung.
In der Praxis
Am 16. November 2026 schloss der dichte 206,16M-Parameter-Pfad nach Behebung einer Zwei-Schritt-Labelverschiebung und dem Entfernen schablonenhafter Nachtrainingsmuster eine 4.850-Schritte-Sonde über 1,271 Milliarden Tokens ab. Der Bits-per-Byte-Wert (BPB) sank stetig von 2,8395 zu Beginn auf 1,7229 bei 500M, 1,6142 bei 1B und 1,4871 bei 1,271B Tokens und belegt echten Sprachlernfortschritt, während der saubere 3-Shot-Test ohne Feinschliff 0,25% (1 von 400) wegen typischer Wiederholungsschleifen unterhalb von 3 bis 4 Milliarden Tokens erreichte.
Auf Basis dieser offenen Messung wächst die zweisprachige Kuration (Portugiesisch und Englisch) von 1,8 auf 4,5 Milliarden Bildungstokens (2,7 Milliarden neu kuratierte Tokens mit SHA-256-Prüfsummen und Speicherschutz `resource_guard`) vor dem vollen Vortraining und einem vielfältigen Feinschliff über 6.000 Beispiele.
Messungen mit dem 393,6M-Checkpoint `v4d` belegen den Effekt: Auf 400 isolierten Testfragen stiegen reine Gewichte von 9,0% auf 21,75% (87/400), das Gesamtsystem (Spalte B) erreichte 59,50% (238/400). Auf einem frischen 96-Fragen-Satz lagen reine Gewichte bei 22,92% (bewusst unter der 35%-Marke), während der Doppelpfad 56,25% erzielte, darunter 12/12 bei expliziter Lückenkalibrierung und 12/12 bei technischer Übersetzung.
Im öffentlichen API-Modus startet der Server ohne gültigen SHA-256-Schlüssel gar nicht, blockiert offene CORS-Platzhalter und lädt Gewichte ausschließlich über `weights_only=True`. Auf dedizierter Server-GPU (`bf16`) maß die Laufzeitumgebung 129,0 Tokens pro Sekunde im Decode.
Was diese Funktion nicht ist
- Der dichte 206,2M-Pfad ab Basis steht noch am Anfang: Bei 1,271B Tokens fiel der BPB auf 1,4871, doch die saubere 3-Shot-Prüfung blieb bei 0,25% (unter der 28%- und BPB-1,14-Schwelle) durch Wiederholungen; vor Abschluss der 4,5B-Tokens und des Feinschliffs erscheint ECBT daher nicht als offener Sequenz-Chat.
- Reine Modellgewichte (22,92% im frischen Test) werden niemals ohne deterministische Werkzeug- und Quellenschicht freigegeben.
- Keine Ausgabe ersetzt Feldproben, akkreditierte Laborberichte, physikalische Simulationen oder die Unterschrift unter dem ECBYTS-Siegel.
- Gemessene 129,0 Tokens/s gelten nur für den deklarierten GPU-Vertrag in `bf16`, nicht für Laptops mit 4 GB Grafikspeicher.
So üben Sie
Mehr zu verlässlicher KI-Kopplung bieten die Beiträge über deterministische digitale Zwillinge und KI und das ECBYTS-Siegel für KI-Berichte. Direkt zur Plattform auf ecbyts oder zum Kontaktformular.