 ecbyts
Как ecbyts разрабатывает собственную языковую модель ECBT
Время чтения: около 4 мин
- Руководство
- Аудио
Построенная на PyTorch с детерминированным двойным контуром компактная модель ECBT разделяет генерацию текста, точный расчет и пробелы данных.
Универсальные языковые модели пишут гладко, но допускают три критические ошибки в экологическом проектировании: угадывают промежуточные величины в расчетах масс и разбавления, игнорируют пробелы наблюдений и требуют передачи конфиденциальных данных во внешние облака. С июля 2026 года ecbyts разрабатывает собственную модель ECBT на чистом PyTorch специально для цифровых двойников и гидрогеологии.
Зачем экологической инженерии собственная языковая модель
При работе с рядами данных по десяткам скважин в mg/L и m3/d обычные ассистенты путают размерности и заполняют отсутствующие замеры по текстовой вероятности. Без прямой привязки к исходным пробам любое сгенерированное число теряет инженерную достоверность.
Не менее важны вычислительные ресурсы и происхождение данных. Гигантские открытые модели требуют облачных кластеров с несколькими GPU, а рабочие станции инженеров ограничены по видеопамяти. Зависимость от чужих API мешает проверять лицензии обучающих выборок, фильтровать персональные данные и контролировать утечки тестов.
Как ecbyts решает эту задачу
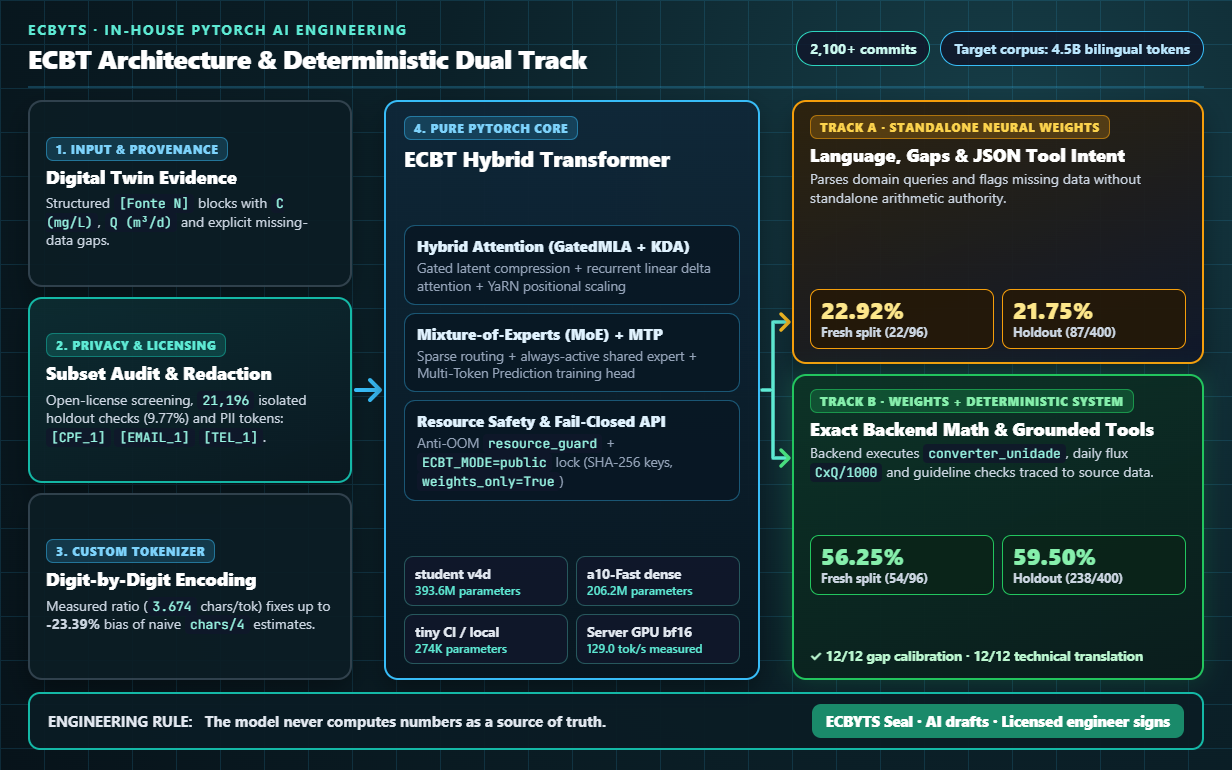
За более чем 2 100 коммитов репозиторий ECBT исследует гибридное внимание (сжатое латентное внимание GatedMLA и линейное рекуррентное внимание KDA) вместе с архитектурой Mixture-of-Experts (MoE), масштабированием YaRN и предсказанием нескольких токенов (MTP). Для практики приоритет отдан компактным моделям: ~394M параметров `student`, плотной ветке 206,2M и профилю `tiny` на 274K для непрерывных проверок.
Главное архитектурное решение состоит в Двойном контуре, отделяющем нейронные веса (Колонка A) от детерминированного системного слоя (Колонка B). Модель распознает запрос, читает структурированные блоки `[Fonte N]`, отмечает заявленные пробелы и формирует типизированный JSON-вызов. Пересчет единиц, суточную массу (`C x Q / 1000`) и сравнение с нормативами выполняет только детерминированный код бэкенда.
Замеры собственного токенизатора доказали, что грубая оценка `символы/4` занижает реальный бюджет до 23,39% в технических текстах на португальском, поэтому числа разбиваются по одной цифре. Все корпуса проходят полицензионный аудит, изоляцию 21 196 контрольных примеров (9,77%) и маскирование личных меток (`[CPF_1]`, `[EMAIL_1]`, `[TEL_1]`).
На практике
16 ноября 2026 года после исправления сдвига меток на два шага и удаления повторяющихся шаблонов дообучения плотная ветка с нуля на 206,16 млн параметров завершила зонд предобучения на 4 850 шагов (1,271 млрд токенов). Потери в битах на байт (BPB) стабильно снижались с 2,8395 в начале до 1,7229 на 500M, 1,6142 на 1B и 1,4871 на 1,271 млрд токенов, подтверждая реальное усвоение языка, тогда как чистая 3-shot проверка без дообучения показала 0,25% (1 из 400) из-за циклов повторения, типичных до отметки от 3 до 4 млрд токенов.
Опираясь на эту открытую диагностику, автономный конвейер отбора двуязычного корпуса (португальский и английский) расширяет базу с 1,8 до 4,5 млрд токенов (плюс 2,7 млрд очищенных токенов с суммами SHA-256 и защитой `resource_guard`) перед полным предобучением и разнообразным дообучением на 6 000 примеров.
Испытания чекпоинта `v4d` (393,6 млн параметров) подтверждают эффект подхода. На 400 контрольных задачах чистые веса выросли с базовых 9,0% до 21,75% (87/400), а связка с детерминированной системой (Колонка B) достигла 59,50% (238/400). На свежем независимом срезе из 96 задач чистые веса набрали 22,92% (ниже целевого порога 35%), но Колонка B подняла точность до 56,25%, включая 12/12 по калибровке пробелов и 12/12 по техническому переводу.
В публичном режиме сервер не запускается без ключа, хранит только SHA-256 хеши, запрещает открытый CORS и загружает веса с флагом `weights_only=True`. На выделенной серверной GPU в `bf16` скорость декодирования составила 129,0 токенов в секунду.
Чем эта функция не является
- Плотная ветка с нуля на 206,2M находится на ранней шкале: на 1,271 млрд токенов BPB снизился до 1,4871, но 3-shot оценка осталась на 0,25% (ниже порога 28% и BPB до 1,14) из-за повторений, поэтому до завершения полного цикла 4,5 млрд токенов и дообучения модель не открывается как последовательный чат.
- Чистые веса (22,92% на свежем срезе) никогда не используются самостоятельно без детерминированного слоя расчетов и ссылок.
- Модель не заменяет отбор проб, аккредитованные лабораторные протоколы, физические расчеты или подпись ответственного специалиста под Печатью ECBYTS.
- Показатель 129,0 токенов/с относится строго к заявленному GPU-контракту в `bf16` и не применим к ноутбукам с 4 ГБ VRAM.
Как практиковаться
Подробнее о детерминированной привязке читайте в статьях детерминированный цифровой двойник и ИИ и Печать ECBYTS для отчетов с ИИ. Перейдите на ecbyts или откройте форму обратной связи.