 ecbyts
Cara ecbyts mengembangkan model bahasa mandiri ECBT
Perkiraan waktu baca: 4 menit
- Panduan
- Audio
Berbasis PyTorch dengan jalur ganda deterministik, model ringkas ECBT memisahkan penalaran bahasa, hitung alat presisi dan celah bukti tanpa mengarang angka.

Model bahasa umum mampu menulis paragraf rapi, namun gagal pada tiga kebutuhan utama rekayasa lingkungan: menebak angka perantara dalam hitungan beban atau pengenceran, mengabaikan kampanye pemantauan yang kosong dan mengharuskan unggahan data proyek sensitif ke server eksternal. Sejak Juli 2026, ecbyts mengembangkan model ECBT secara internal dengan PyTorch murni bagi kembar digital dan hidrogeologi.
Mengapa rekayasa lingkungan butuh model bahasa sendiri
Saat tim memeriksa deret historis puluhan sumur pantau dengan satuan mg/L dan m3/d, asisten umum mencampur basis satuan serta mengisi celah data berdasarkan probabilitas teks. Tanpa tautan langsung ke data ukur asli, angka apa pun kehilangan dasar teknisnya.
Batasan komputasi dan asal-usul data juga menentukan. Model terbuka raksasa menuntut klaster multi-GPU mahal, sedangkan komputer kerja memiliki kapasitas memori terbatas. Bergantung pada layanan pihak ketiga menghambat audit lisensi pelatihan, penyaringan data pribadi dan uji bebas kebocoran.
Cara ecbyts menyelesaikannya
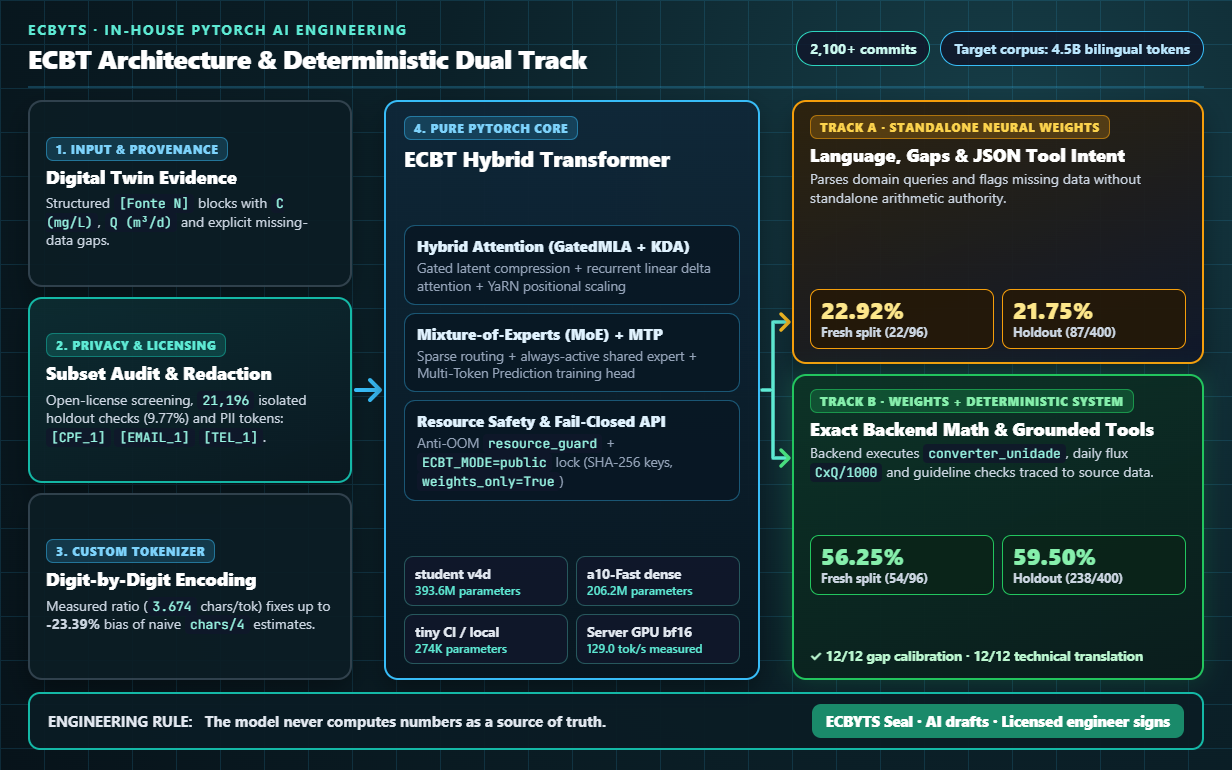
Dengan lebih dari 2.100 commit rekayasa, repositori ECBT menguji blok atensi hibrida (menggabungkan GatedMLA terkompresi dan atensi linier rekuren KDA) bersama perutean Mixture-of-Experts (MoE), penskalaan YaRN dan prediksi multi-token (MTP). Untuk efisiensi nyata, fokus diarahkan ke profil ringkas seperti `student` 394 juta parameter, jalur padat 206,2 juta dan profil `tiny` 274K untuk uji otomasi.
Keputusan intinya ialah Jalur Ganda yang memisahkan bobot saraf (Kolom A) dari lapisan sistem deterministik (Kolom B). Model membaca maksud pengguna dan blok `[Fonte N]`, menandai kekosongan data resmi serta menyusun panggilan alat JSON terstruktur. Konversi satuan, beban massa harian (`C x Q / 1000`) dan baku mutu dihitung murni oleh backend deterministik.
Pengukuran langsung dengan tokenizer sendiri membuktikan aturan `karakter/4` meremehkan teks teknis hingga 23,39%, sehingga diterapkan pemecahan angka digit demi digit. Setiap subkumpulan menjalani pemeriksaan lisensi, isolasi 21.196 data uji (9,77%) serta penyamaran otomatis (`[CPF_1]`, `[EMAIL_1]`, `[TEL_1]`).
Dalam praktik
Pada 16 November 2026, setelah memperbaiki pergeseran dua langkah pada label pelatihan dan menghapus templat penyetelan berulang, jalur padat dari nol berkapasitas 206,16 juta parameter menuntaskan uji pra-pelatihan 4.850 langkah atas 1,271 miliar token. Rugi bit per bita (BPB) turun konsisten dari 2,8395 di awal ke 1,7229 pada 500M, 1,6142 pada 1B, dan 1,4871 pada 1,271 miliar token, membuktikan pembelajaran bahasa nyata, sedangkan uji bersih 3-contoh tanpa penyetelan mencatat 0,25% (1/400) akibat putaran pengulangan yang lazim di bawah 3 hingga 4 miliar token.
Dipandu oleh pengukuran terbuka tersebut, kurasi dwibahasa (Portugis dan Inggris) memperluas korpus dari 1,8 menuju 4,5 miliar token edukatif (menambah 2,7 miliar token tersaring dengan manifes SHA-256 dan pelindung memori `resource_guard`) sebelum pra-pelatihan penuh dan penyetelan halus beragam atas 6.000 contoh.
Uji terkendali pada checkpoint `v4d` 393,6 juta parameter membuktikan manfaat pendekatan ini. Pada 400 soal uji terisolasi, bobot murni naik dari 9,0% menjadi 21,75% (87/400), sementara sistem terpadu Kolom B mencapai 59,50% (238/400). Pada 96 soal baru di delapan kategori, bobot murni mencatat 22,92% (di bawah target mandiri 35%), sedangkan Kolom B meraih 56,25%, termasuk 12/12 dalam kalibrasi celah bukti dan 12/12 pada terjemahan teknis.
Dalam keamanan operasional, mode publik menolak berjalan tanpa kredensial, menyimpan kunci hanya dalam hash SHA-256, menutup CORS terbuka dan memuat bobot dengan `weights_only=True`. Pada GPU server khusus `bf16`, runtime mencatat kecepatan decode 129,0 token per detik.
Batasan fitur ini
- Jalur padat 206,2M dari nol masih berada di skala awal: pada 1,271 miliar token BPB turun ke 1,4871, tetapi uji bersih 3-contoh bertahan di 0,25% (di bawah ambang 28% dan BPB 1,14) akibat pengulangan; karena itu ECBT belum dirilis sebagai obrolan beruntun terbuka sebelum siklus 4,5 miliar token dan penyetelan selesai.
- Bobot model murni (22,92% pada uji baru) tidak pernah dipakai mandiri tanpa lapisan hitung deterministik dan rujukan sumber.
- Tidak ada keluaran model yang menggantikan pengambilan sampel lapangan, laporan laboratorium terakreditasi, simulator fisika atau tanda tangan ahli di bawah Segel ECBYTS.
- Kecepatan 129,0 token/detik hanya berlaku pada kontrak GPU khusus dan presisi `bf16` yang diuji, bukan laptop dengan VRAM 4 GB.
Cara berlatih
Pelajari keterhubungan sistem deterministik dan kecerdasan buatan pada artikel kembar digital deterministik dan AI serta Segel ECBYTS untuk laporan berbantuan AI. Kunjungi ecbyts atau hubungi tim melalui halaman kontak.